一番わかりやすいガウス過程回帰
はじめに
ガウス過程回帰(Gaussian Process Regression, GPR)は、予測値だけでなく予測の不確かさ(信頼区間)まで自然に出してくれるベイズ的な回帰手法である。データが少ない領域では「自信がない」とちゃんと言ってくれる、とても誠実なモデルだ。

これがガウス過程回帰の実例だ。黒い点線が真の関数、赤い点が観測データ、青い実線が予測平均、水色の帯が95%信頼区間である。観測データの近くでは帯が狭く、データのない右端(外挿領域)では帯が大きく広がっているのが分かる。この記事は、この図がどういう理屈で出てくるのかを、一歩ずつ説明していく。
ガウス過程回帰の入門書として、↓があり、Amazonのレビューでもわかりやすいと評判なのだが、0.3節、0.5節、3章あたりで、話がつながっていなくて、私としては納得いかない。正直、これでは「わからない」、「わかっている人が導いた結論を暗記してわかった気になっているだけ」と感じた。
なので、自分で私が納得いくように書いてみた(というか、AIに何度も書き直させてわかりやすい文を生成した)。
この記事では、数式の意味を噛み砕きながら、GPRの考え方を順を追って説明する。
1. 前提知識1:正規分布まわりの基礎
ガウス過程回帰と聞くと身構えてしまうが、その中身はよく知られた道具を組み合わせて、無限次元に広げただけである。本編に入る前に、2つの章に分けて前提知識を準備する。第1章では確率側の道具(正規分布まわりの基礎)を、第2章では回帰側の道具(回帰モデルの作り方)を押さえる。
この章で押さえるのは次の4つだ。
- 正規分布(1-1) … データのばらつきを表す、いちばん基本的な分布。
- 共分散と相関(1-2) … 複数の変数が「どれくらい一緒に動くか(連動するか)」を測るものさし。
- 条件付き分布(1-3) … 一部の変数を観測したとき、残りの変数がどう絞り込まれるか。これが「予測」の正体である。
- 多変量正規分布への拡張(1-4) … 2変数の話を一般の
変数へ。
いちばんシンプルな2変数(2次元)の正規分布を出発点に、順に見ていこう。
1-1. 正規分布 ―― まず2変数で感覚をつかむ
1次元の正規分布(ガウス分布)は、平均 を中心に左右対称な釣鐘型をした、おなじみの分布である。ばらつきの大きさは標準偏差
(その2乗
を分散と呼ぶ)で決まり、記号では
と書く。「
は平均
・分散
の正規分布に従う」という意味で、
は Normal(正規)の頭文字、
は「〜に従う」を表す記号である。
これを2変数に広げてみよう。2つの確率変数 がペアで正規分布に従うとき、その確率密度は「山」の形になる。1次元の正規分布が釣鐘型の曲線だったのに対し、2次元ではお椀を伏せたような曲面になる。

- 左(3D曲面):中心がいちばん高く、外側に向かってなだらかに低くなる。これが2次元正規分布の「山」。
- 右(等高線):山を真上から見たもの。等高線が楕円になっているのがポイントである。
この分布は次の2つで完全に決まる。
- 平均ベクトル
… 山の頂点の位置
- 共分散行列
… 山の「広がり方」。対角成分
が各方向の広がり、非対角成分が
と
の連動の強さ(相関
)を表す。
1-2. 共分散と相関 ―― 変数の「連動」を測る
1-1の共分散行列で「連動の強さ」と呼んだものを、ここできちんと定義する。2つの変数がどれくらい一緒に動くかを測る量が共分散(covariance) で、 と書く。
ここで は期待値(たくさんサンプルを取って平均する操作)を表す記号である。式の気持ちはこうだ ――
が平均
より大きいとき
も平均
より大きい、というように同じ向きに動く傾向があれば
は正になりやすく、共分散は正の大きな値になる。逆向きに動けば負、無関係ならゼロ付近になる。
ただし共分散の値は各変数のスケール(単位)に依存してしまい、大小をそのまま比べにくい。そこで各標準偏差 で割って
〜
に正規化したものが相関係数
である。
共分散にはコーシー・シュワルツの不等式 が成り立つので、両辺を
で割れば、
は必ず次の範囲に収まる。
… 完全な正の比例(片方が決まればもう片方も一意に決まる)
… 線形な関係がまったくない
… 完全な負の比例
両端の は「2変数が直線関係に退化する」極限であり、それより外側(
)はあり得ない。
では、この相関 を
から
まで実際に動かすと、2変数正規分布の形(等高線の楕円)がどう変わるかを見てみよう。
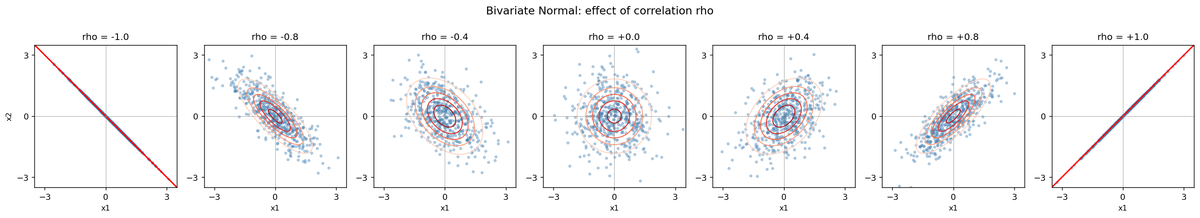
に完全に乗り、分布が直線につぶれる(共分散行列が特異になる)。
:右下がりの楕円が、だんだん丸くなる。
:右上がりの楕円が、だんだん細くなる。
につぶれる。
「傾き」と誤解しがちだが、つぶれ具合を表す。「傾き」は正負の2通りのみで、絶対値で楕円の「細さ」が変わるイメージだ。
両端()に近づくほど楕円が細くなる=片方を知れば、もう片方がほぼ確定することを表す。逆に中央(
)では円形で、片方を知っても何も分からない。
1-3. 条件付き分布 ―― 観測から残りを推測する
💡 ここが超重要:相関があるということは、「片方の値を知ると、もう片方の値が推測できる」ということだ。これがガウス過程回帰のすべての出発点である。
この「片方を知ると、もう片方が推測できる」を確率の言葉にしたのが条件付き分布である。
では、 の値を実際に観測したらどうなるだろうか? たとえば
だったとしよう。
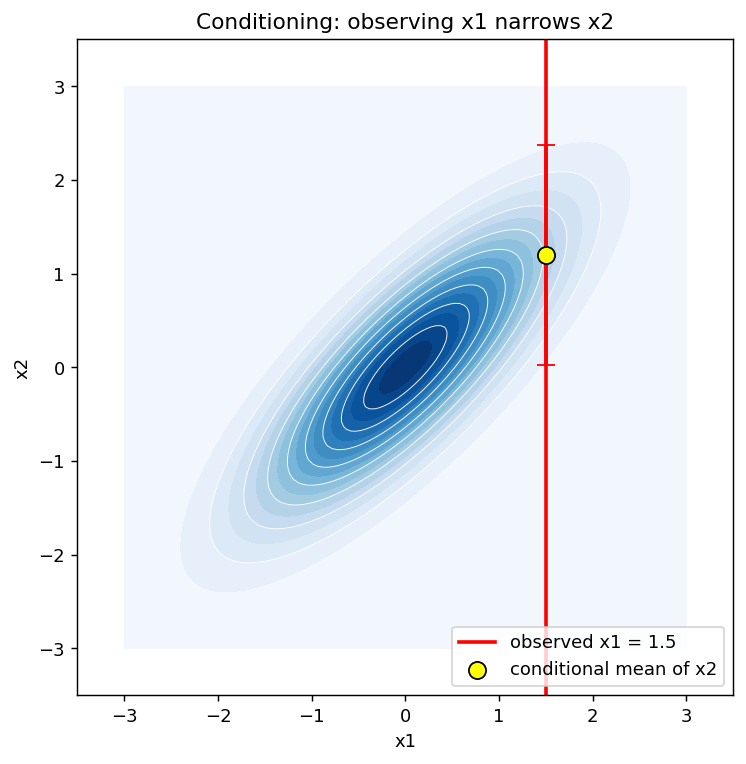
赤い縦線()の上だけを見ると、
がどのあたりにありそうか、範囲がぐっと狭まるのが分かる。これが条件付き分布
である。記号の縦棒
は「〜を与えたとき(〜という条件のもとで)」という意味で、
は『
と分かっているもとでの
の分布』を表す。そしてこの条件付き分布もまた正規分布になる。
その条件付き分布を、横軸 の正規分布として描いたのが下の図である。観測前(
を知る前)の
の分布
(黒い点線)に比べ、
を観測した後の分布(赤)は、中心が右にずれ、山が鋭く尖っている=平均が移動し、ばらつき(分散)が小さくなっていることが分かる。

正の相関 があるので、「
が平均より大きい →
も平均より大きいはず」と予測される。実際、上の図の山(条件付き平均)は中心より右にずれている。具体的な式は次の通りだ(
のとき)。
ここで は1-2で出てきた期待値(平均)、
は分散(1-1で出てきた
、つまりばらつきの大きさ)を表す。
を入れると、条件付き平均は
、条件付き標準偏差
は
。観測前は分散1だったのが、観測後は分散
に縮んでいる。つまり「
を観測したことで
の不確かさが減った」わけだ。観測 → 条件付き分布で残りを絞り込む。これがそのまま「予測」になる。
1-4. 多変量正規分布への拡張
ここまでは2変数だったが、変数を一般の 個に増やしても話はまったく同じだ。2変数の正規分布を多次元に拡張したのが多変量正規分布で、平均ベクトル
と共分散行列
で決まる。
共分散行列 は「変数同士がどれくらい連動するか」を表す。
個の変数があるときは、
の行列になり、その
成分は次のように書ける。
- 対角成分
… 各変数
の分散(その変数単独の広がり)。
- 非対角成分
… 変数
の連動の強さ。
ここで注目してほしいのは、この非対角成分 が、1-1の2変数のときに出てきた
とまったく同じ形だということだ。つまり多変量正規分布の共分散行列は、この「2変数の話」を、すべてのペア
について並べて埋めただけなのだ。1つ1つの成分を見れば、やっていることは2変数のときと何も変わらない。そして多変量正規分布でも、一部の変数を観測すれば残りの条件付き分布(=予測)が正規分布として求まるという性質はそのまま成り立つ。
2. 前提知識2:回帰モデルの作り方
ここからは見方を変えて、もう1本の柱「重み空間ビュー」を準備する。第1章とは独立した話なので、いったん頭を切り替えてほしい。押さえるのは次の3つだ。
- 特徴空間での線形回帰(2-1) … 基底関数を使って、線形回帰のまま曲線を表す。
- カーネルトリック(2-2) … 特徴ベクトルを陽に計算せず、内積だけで回帰する技法。
- ガウシアンカーネル(2-3) … 代表的なカーネル。実は「無限個の基底を使った線形回帰」になっている。
2-1. 特徴空間での線形回帰
ふつうの線形回帰 は直線しか表せない。これではサインカーブのような曲線にはフィットできない。そこで、入力
をそのまま使うのではなく、いくつかの決まった形の関数
を用意し、その重み付き和で関数を表す。
この を基底関数、基底関数が張る空間を特徴空間と呼ぶ。普通の多項式も、
を基底関数とした特徴空間とみなすことができる。下の図のようなガウス・バンプ(あちこちに置いた小さな山)も基底関数としてよく使われる。ポイントは、
が重み
については相変わらず線形(1次式)だということ。だから「線形回帰」のままなのに、
のおかげで曲線を表現できる。

- 左:9個のガウス・バンプ基底
。それぞれ別の場所に山がある。
- 右:重み
をいろいろ変えて足し合わせた
。基底の重みを変えるだけで、いろいろな滑らかな曲線が作れることが分かる。
あとは、観測データに合うように重み を決めれば回帰の完成だ。
学習データ 個の特徴ベクトルを縦に積んだ行列を
とする(
行目が
、サイズは
)。まず、いちばん素朴な最小二乗で重み
を求めると、解は
となる。
これでも良いのだが、 が逆行列を持たないとゼロ除算のような問題が生じる。そこで、小さな正則化項
を足した最小二乗(リッジ回帰)で重みを決める。
次の2-2では、この特徴空間での線形回帰で実際に予測をしてみると、何が起こるかを見る。
2-2. カーネルトリック
2-1の特徴空間での線形回帰で、実際に新しい点 の出力を予測してみよう。すると、思いがけない事実が見えてくる。
2-1のリッジ回帰で求めた重み を使うと、
における予測値は次の式で与えられる。
ここで、線形代数の次の恒等式(push-through identity)を使ってみる。
左辺は の逆行列、右辺は
の逆行列で、両辺は厳密に等しい(行列サイズだけが
から
に入れ替わる)のがポイントだ。これを予測値に代入すると、こうなる。
ここで が登場するのは
と
の2か所だけだ。その中身を書き下してみると ――
なんと、 は必ず2つペアになった内積
の形でしか出てこないのだ。
が単独で残る場所はどこにもない。
つまり、予測を実行するのに必要なのは特徴ベクトルそのものではなく、2点の内積の値だけだった、というわけだ。それなら、この内積をいちいち 経由で計算するのはやめて、まとめて1つの関数(カーネル)として定義してしまおう。
これがカーネルトリックである。うれしいのは次の点だ。
を一つ一つ計算しなくても、内積
さえ計算できれば回帰ができる。
- だから基底の数
が巨大でも、いや無限大でも、
が有限の値で計算できるなら問題ない。
最後の点が決定的だ。無限次元の特徴空間を、計算上は有限サイズのカーネルの値だけで扱えてしまう。次章以降で見るように、ガウス過程回帰はまさにこの「無限次元を有限の計算で回す」仕掛けの上に成り立っている。
2-3. ガウシアンカーネル ―― 実は「無限個の基底」
2-2で「カーネル さえあれば、特徴ベクトルを陽に持たなくても回帰できる」ことを見た。では具体的なカーネルとして、いちばんよく使われるRBFカーネル(ガウシアンカーネル、別名 squared exponential)を見てみよう。
(length scale)… 関数の「滑らかさ」「変化の細かさ」を決める。大きいとなめらか、小さいとぐにゃぐにゃ。
… 関数の振れ幅(縦方向のスケール)。
と
を実際に動かすと、カーネルの形は次のように変わる。
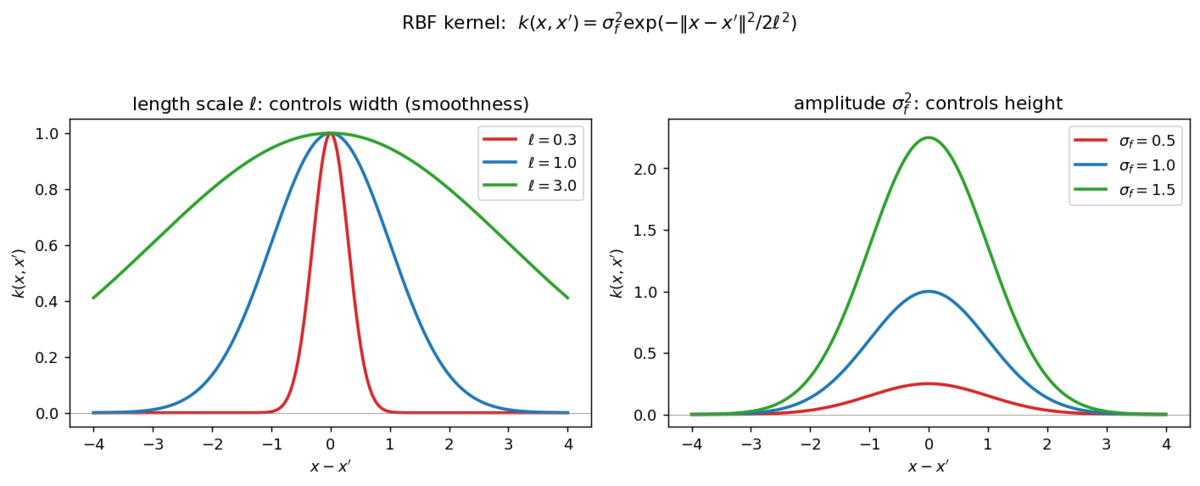
- 左:
- 右:
直感的には、入力 と
が近ければカーネル値が大きく(=出力が強く相関し)、遠ければ小さくなる(=ほぼ無関係)という性質を表している。「近いものは似た値を取るはず」という素直な仮定だ(1-2の相関を思い出してほしい。カーネルは「2点がどれくらい相関するか」を与える関数である)。
正体は「無限個の基底」
このRBFカーネルは、いったいどんな基底関数 の内積なのだろうか。
として実際に展開してみる。
ここで指数関数をテイラー展開 すると、
つまりガウシアンカーネルは、
という無限個の基底関数の内積になっているのだ。和が から
まで走っていることに注目してほしい。これが下の図の各成分である。
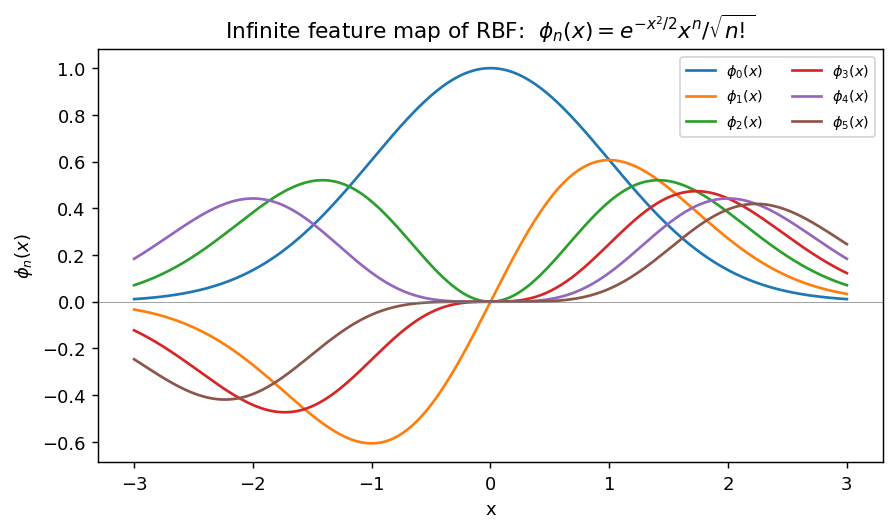
(釣鐘型)、
(1回うねる)、
(2回うねる)… と、次数が上がるほど複雑な形になる。RBFカーネルを使うということは、この無限個の基底をすべて使った線形回帰をしているということだ。2-2のカーネルトリックのおかげで、無限個の基底を陽に扱わずに、有限の値
だけでそれを回せるわけである。
数値で確かめる:有限の内積が無限次元の極限でRBFになる
個の有限なランダム特徴(Random Fourier Features)の内積を足し合わせていくと、
を増やすにつれて確かにRBFカーネルへ近づいていく。その様子を数値で確認してみよう。下の図は、その内積をカーネルとして計算し、真のRBFカーネル(黒線)と重ねたものである。
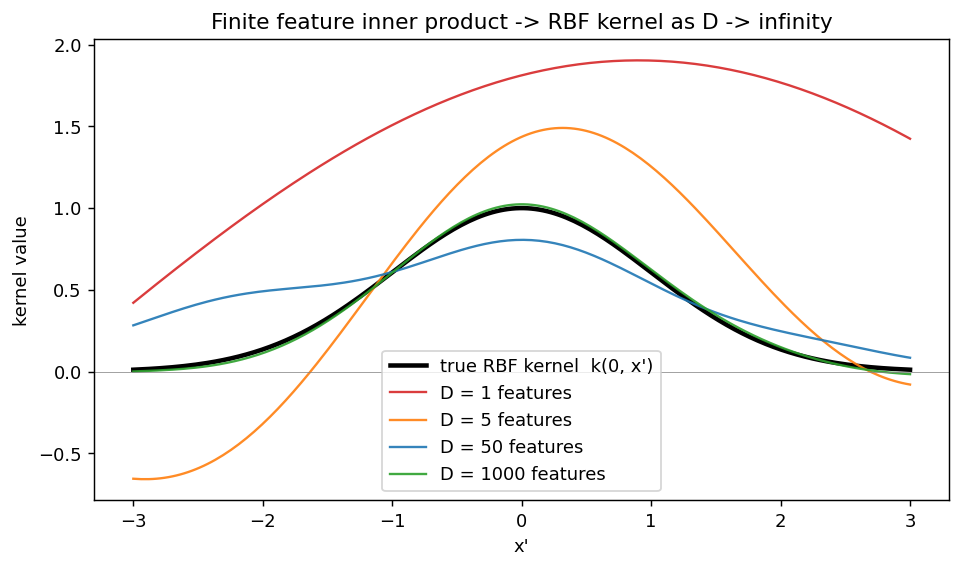
:ぜんぜん合っていない(有限次元では再現できない)。
:かなり近い。
:黒線とほぼ完全に一致。
つまり RBF カーネルは有限個の基底の内積では決して厳密に表現できず、基底の数を無限に飛ばした極限としてのみ得られる。これが「ガウシアンカーネル=無限個の基底」という主張の数値的な裏付けだ。
まとめ:前提知識がそろった
第1章と第2章を振り返ると、ガウス過程回帰の材料はもうそろっている。
正規分布まわりの基礎(第1章)
- 複数の変数がまとめて正規分布に従う(=共分散行列で連動している)
- 一部の変数を観測する
- 残りの変数の条件付き分布(=予測)を計算する。これも正規分布で、平均(予測値)と分散(不確かさ)が綺麗な式で出る
回帰モデルの作り方(第2章)
- 基底関数の重み付き和でなめらかな関数を作る(特徴空間での線形回帰)
- カーネルトリックで、内積さえあれば無限次元の特徴空間でも計算できる
- ガウシアンカーネルは、実は無限個の基底を使った線形回帰になっている
ただし、ここまでの回帰モデルは重みを最小二乗で1つに決める、確率とは無縁の世界だった。次章では、この回帰モデルに第1章で準備した確率論を導入する。すると関数そのものが確率変数になり、ガウス過程回帰が出来上がる。
3. ガウス過程回帰のしくみ
ここからが本編だ。まず第2章の回帰モデルの重みに事前分布を置き、関数そのものを確率変数として表す(3-1)。この「関数の確率分布」がどんな性質を持つかを調べ、ガウス過程として定義する(3-2)。次に、有限次元のベイズ線形回帰で具体的に確認したうえで(3-3)、カーネルトリックを使って同じ結果をカーネルだけで解き直し(3-4)、最後にハイパーパラメータの学習(3-5)まで、一気に組み上げる。
3-1. 関数を確率変数として表す
私たちがやりたいのは回帰、つまり観測データから未知の関数 を求めることだ。ガウス過程の発想は思い切っていて、関数そのものを、1つに決まらないランダムな量(確率変数)として扱ってしまうというもの。具体的には、抽選を1回するたびに関数が1本まるごと出てくる、という状況を作る。難しそうに聞こえるが、実は2-3のガウシアンカーネルに、重みをランダムな値にするという考え方を組み合わせるだけで作れる。
2-3で、RBFカーネルは無限個の基底 を持つことを見た。この基底の重み付き和で関数を表し(2-1)、その重み
を1つの値に固定せず、確率分布として考える。
ではデータを見る前、重みはどんな分布だと考えればよいだろうか。まだ何のデータも得ていない段階では、各係数 がプラスかマイナスか、どのくらいの大きさかについて何の情報もない。そこで「どちらに偏るとも言えない(平均0)」「各重みは互いに独立で、ほどほどの大きさにばらつく(分散1)」という、いちばん素直な分布を事前分布とする。これをまとめて書くと、平均ベクトル
・共分散行列
(単位行列)のガウス分布だ。
重み がランダムなので、その和である関数
もまるごとランダムになる。サイコロを振る(
を1セット抽選する)たびに、関数が1本まるごと出てくる――これが「関数を確率変数として表す」ということだ。
2-1の右図で「重みをいろいろ変えて描いた曲線」は、まさにこの確率分布から関数を抽選したサンプルだった。
ここで「無限次元」の意味もはっきりさせておこう。ランダムなのは無限個の重み である。つまり、この「抽選するたびに関数が1本出てくるしくみ」の正体は、無限個の重み
が従う、無限次元のガウス分布
そのものにほかならない。
3-2. ガウス過程の定義
この「抽選するたびに関数が1本出てくるしくみ」がどんな性質を持つか調べよう。回帰で知りたいのは、結局いくつかの入力点での関数の値だ。そこで、任意の有限個の点 を選んで、関数値のベクトル
に注目する。各値は
という、ガウス分布に従う の線形変換である。ガウスの線形変換はまたガウスになるので、次のことが言える。
どんな有限個の点
を選んでも、関数値
は多変量正規分布に従う
その平均は0だ(3-1で置いた事前分布で、重み の平均が0だから)。共分散は、
どうしが独立・分散1であることを使って計算すると
――2-3で見た展開そのもので、ちょうどRBFカーネルの値になる。つまりカーネルとは「2点の関数値がどれくらい連動するか(共分散)」を与える関数だったのだ。1-2の相関の話を思い出してほしい。カーネルはまさに、共分散行列の各成分を生成する関数である。
この性質を持つ「抽選するたびに関数が1本出てくるしくみ」をガウス過程(Gaussian Process, GP)と呼び、次のように書く。
- 平均関数
… 各
での関数値の平均。ここでは
- カーネル関数(共分散関数)
… 2点
の関数値の共分散
ガウス分布が平均と共分散で完全に決まるのと同じように、ガウス過程もこの2つで完全に決まる。
無限次元なのに、なぜ計算できるのか
ランダムな重みは無限個(=無限次元のガウス分布)だった。計算不能に思えるが、実用上は心配いらない。私たちが本当に知りたいのは、手元の有限個の点(学習データと予測したい点)における関数値だけで、上で見たとおり、そこだけ見ればいつでも普通の(有限次元の)多変量正規分布になるからだ。しかもその共分散行列の成分は、無限個の基底を一切経由せずに、カーネルの値 として直接計算できる(2-2のカーネルトリック)。
つまり、あとは1-3〜1-4でやった「一部を観測して、残りを条件付き分布で絞り込む」に持ち込むだけである。実際の計算は3-4で行う。その前に次節では、ここまでの話を有限次元の具体例(ベイズ線形回帰)で確認しておこう。
3-3. 有限次元で確かめる ―― ベイズ線形回帰
3-1・3-2では、重み に事前分布
を置くことで、関数がガウス過程になることを見た。ここでは、その具体例として、有限次元の特徴空間で実際にベイズ線形回帰を行い、事前分布→事後分布→予測という流れを確認する。この結果は、3-4で見るガウス過程による予測と(カーネルトリックを通じて)一致する。
事前分布を用意したうえでデータ が得られたら、次の2つができる ―― (1) 重みの分布を「データを見た後」の姿に更新する(事後分布)、(2) それを使って新しい点の出力を予測する。順に見ていこう。
① データから重みの事後分布を求める
まず、観測のモデルを決める。観測値 は、特徴空間での線形回帰の値
に、避けられない観測ノイズ
が乗ったものだと考える。
ノイズが平均0・分散 のガウス分布なので、この式は「重み
を1つ仮に決めたとき、観測
がどれくらいの確からしさで得られるか」という確率
を与える。これを尤度(ゆうど)と呼ぶ(「
が与えられたときの
のもっともらしさ」という意味)。
次にベイズの定理を使う。これは「データを見る前の信念(事前分布)」を「データを見た後の信念(事後分布)」へ更新するための公式で、
と書ける( は「比例する」の意味。全体が確率1になるよう正規化するだけなので、形を追う分には比例で十分だ)。直感的には、最初の素直な事前分布
に、観測データの「裏付け」(尤度)を掛け合わせて、データと整合する重みへ絞り込む操作だ。この絞り込んだ結果
が事後分布である。
実際に計算すると(ガウス分布どうしの積はまたガウス分布になり、指数の肩を について平方完成すれば求まる。導出は付録Aを参照)、事後分布もきれいにガウス分布になる。
ポイントは、事前分布 が、データを見たことで平均
・共分散
のガウス分布へ更新されたということ(3-2で見た「平均0」の事前分布が、ここで初めて0でない平均を持つように更新される)。データが教えてくれた分だけ重みの不確かさ(
の広がり)も縮む。これがベイズ線形回帰における「学習」の中身だ。
② 新しい点の出力を予測する
事後分布さえ分かれば、新しい入力 での出力
も予測できる。
がガウス分布に従うので、その線形変換である
もガウス分布になり、平均と分散は次のようになる(ガウスの線形変換の公式
、
を当てはめるだけ)。
ここがベイズのうれしいところで、予測が1つの値ではなく「平均 ± 不確かさ」という分布で得られる。予測分散
がそのまま信頼区間の幅になり、データの少ない場所では自然と大きく(自信なく)なる。GPRが「自信のなさ」を出せるのは、この仕組みのおかげだ。
以上がベイズ線形回帰のすべてだ ―― 事前分布を置き → データで事後分布に更新し → 新しい点を分布として予測する。
3-4. カーネルトリックを使って解く
3-3の①②は、有限次元の特徴ベクトル を陽に使って重みを経由する重み空間ビューでの予測だった。カーネルトリックもそのまま使える。 3-3の予測平均をよく見ると、2-1のリッジ回帰にあった正則化項
がちょうど観測ノイズの分散
に置き換わっただけで、数式の骨格はまったく同じだ。だから同じ push-through 恒等式で変形でき、やはり
は内積の形でしか現れない(予測分散も
が2つペアで現れる形なので同様)。最小二乗(点推定)でもベイズ(分布)でも、特徴ベクトルは内積=カーネルとしてしか効かない。この事実のおかげで、ここからは特徴空間
を一切忘れて、カーネル
だけでベイズ的な回帰(=ガウス過程回帰)を組み立てられる。つまりここからは、3-3の①②と数学的に同じ結果を、重み
を経由せずカーネルだけで導く関数空間ビューを見ていく。
設定
学習データ があるとする。
: 入力
: 観測値(ノイズを含む)
観測にはノイズが乗っているとする。
ここで新しい点 における出力
を予測したい。
同時分布を書く
ガウス過程の性質から、観測値 と予測したい値
はまとめて多変量正規分布に従う。
ここで は学習点同士のカーネル値を並べた
の行列だ。
条件付き分布が予測になる
「観測 が分かっている」という条件のもとで
の分布を求める=条件付き分布を計算する。1-3でやった「
を観測して
を絞り込む」のと、まったく同じ操作だ。多変量正規分布の条件付き分布の公式から、答えもまた正規分布になる。
予測平均:
予測分散:
この2本がGPRの核心だ。
- 予測平均は、観測値
の重み付き和になっている(カーネルが「近い学習点ほど重く効く」重みを与える)。
- 予測分散は、学習データから離れた点ほど大きくなる。つまりデータのない場所では「自信がない」と分散が膨らむ。
これが冒頭で述べた「不確かさを出せる」という最大の魅力だ。1-3の「観測後は分散が縮む」という話の、そのまま無限次元版だ。
3-5. ハイパーパラメータの学習
カーネルには といったハイパーパラメータ
がある。これらは周辺尤度(marginal likelihood)の対数を最大化して決めるのが定石だ。
ただし 。
この式は2つの項のバランスで成り立っている。
- 第1項
… データへの当てはまりの良さ
- 第2項
… モデルの複雑さへのペナルティ
つまり周辺尤度の最大化は、過学習を自動的に抑えながら最適なパラメータを選んでくれる(オッカムの剃刀が自然に働く)という、ベイズ的に美しい性質を持つ。
4. Pythonで動かしてみる(scikit-learn)
理屈が分かったら手を動かすのが一番だ。scikit-learn なら数行で試せる。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.gaussian_process import GaussianProcessRegressor
from sklearn.gaussian_process.kernels import RBF, ConstantKernel, WhiteKernel

# --- 真の関数とノイズ付き観測データ ---
def true_f(x):
    return np.sin(x) + 0.3 * x

rng = np.random.default_rng(0)
X_train = np.sort(rng.uniform(0, 10, 8)).reshape(-1, 1)
y_train = true_f(X_train).ravel() + rng.normal(0, 0.2, X_train.shape[0])

# --- カーネル定義:振幅 * RBF + 観測ノイズ ---
kernel = ConstantKernel(1.0) * RBF(length_scale=1.0) + WhiteKernel(0.1)

gpr = GaussianProcessRegressor(kernel=kernel, normalize_y=True, n_restarts_optimizer=10)
gpr.fit(X_train, y_train)

# --- 予測(平均と標準偏差を同時に取得)---
X_test = np.linspace(0, 12, 300).reshape(-1, 1)
y_mean, y_std = gpr.predict(X_test, return_std=True)

# --- 可視化 ---
plt.figure(figsize=(9, 5))
plt.plot(X_test, true_f(X_test), "k--", label="true function")
plt.scatter(X_train, y_train, c="red", zorder=5, label="observations")
plt.plot(X_test, y_mean, "b", label="predictive mean")
plt.fill_between(X_test.ravel(),
                 y_mean - 1.96 * y_std,
                 y_mean + 1.96 * y_std,
                 alpha=0.2, color="blue", label="95% confidence interval")
plt.legend(); plt.title("Gaussian Process Regression")
plt.show()

print("学習されたカーネル:", gpr.kernel_)
実行すると、ブログ冒頭に示したグラフが得られる。
観測点の近くでは信頼区間が狭く、データのない右端(外挿領域)では信頼区間が大きく広がる様子が見える。これこそGPRの真骨頂だ。
ちなみに上の例で学習されたカーネルは次の通りだった。
0.939**2 * RBF(length_scale=1.62) + WhiteKernel(noise_level=0.0408)
length scale ≈ 1.62、観測ノイズ ≈ 0.041 と、データから自動的に妥当な値が推定されている。
5. まとめ:長所・短所と使いどころ
最後に、ガウス過程回帰の長所・短所、使いどころ、そして記事全体の振り返りをまとめる。
長所と短所
長所
- 予測の不確かさを定量化できる(信頼区間が出る)
- データが少なくても機能する(少数データに強い)
- カーネルを通じて事前知識(滑らかさ・周期性など)を柔軟に組み込める
- ハイパーパラメータが周辺尤度で原理的に決まる
短所
- 計算量が
(共分散行列の逆行列計算)。データ数
- 高次元入力では性能が落ちやすい(カーネルの距離が意味を失う)
- カーネル選択がモデルの性能を大きく左右する
※ 大規模データには、補助点を使う Sparse GP(誘導点法) や、SVGPなどの近似手法が使われる。
どんな場面で使う?
- ベイズ最適化 … ハイパーパラメータ探索や実験計画。「次にどこを試すべきか」を不確かさに基づいて決める用途で大活躍。
- 時系列・空間データの補間(クリギングは地統計学版のGPR)
- 少数データでの代理モデル(サロゲートモデル) … 計算コストの高いシミュレーションの代替
全体の振り返り
- 土台は2つ。正規分布まわりの基礎(第1章:正規分布→共分散→条件付き分布→多変量)と、回帰モデルの作り方(第2章:特徴空間での線形回帰→カーネルトリック→無限個の基底)。
- この回帰モデルに確率論を導入し(重みを確率分布にする)、無限個の基底の重み付き和にランダムな重みを入れたものが「確率変数としての関数」。これがガウス過程で、カーネル関数が関数の滑らかさや相関(共分散)を決める。
- つまりガウシアンカーネルを使ったGPRは、無限個の基底によるベイズ線形回帰=無限次元のガウス分布上の推論を、有限のカーネル行列だけで実行している。
- 回帰は多変量正規分布の条件付き分布を計算するだけ。予測平均と予測分散が綺麗な式で出る。
- 最大の魅力は予測の不確かさを定量化できること。
- 計算量
数式は多いが、本質は「正規分布の条件付き分布を取るだけ」だ。一度コードを動かして、信頼区間がデータの密度に応じて伸び縮みする様子を体感すると、一気に腑に落ちるはずだ。
参考文献
- C. E. Rasmussen & C. K. I. Williams, Gaussian Processes for Machine Learning, MIT Press, 2006.(無料公開PDF)
- 持橋大地・大羽成征『ガウス過程と機械学習』講談社
付録A:事後分布の導出(平方完成)
3-3で「指数の肩を について平方完成すれば求まる」とした計算を、ここで丁寧に追う。
出発点:事前分布と尤度の指数部分を書き出す。
事後分布はこの2つの積に比例するので、指数部分を足し合わせる。
ステップ1: について展開する
指数の中身( の
部分)を展開する。
これは の2次の項+1次の項+定数という形になっている。ここで
とおくと、指数の中身は という単純な形になる。
ステップ2:平方完成する
「2次+1次+定数」の形は、平方完成の公式
を使って、 を含む部分を「ちょうど正規分布の指数の形」
にまとめられる。最後の項
は
を含まないので、比例定数に吸収してよい。
ステップ3:係数を読み取る
したがって事後分布は
という、まさに正規分布 の形になっており、
(最後の等式は の
が約分されて出てくる)。これが3-3の式とちょうど一致する。
数式モデル不要!実験データだけでシミュレーションできるCDDS法──MATLABサンプルつき
制御工学とAIをつなぐデータ駆動制御(Data-Driven Control)の流れに注目している。実験データから直接コントローラを設計したり、モデルを作らずに応答を予測したりする手法が次々と提案されている。 そんなデータ駆動の手法として、前の記事でVRFT法、FRIT法、NCbT法を解説した。 manva.hatenablog.com manva.hatenablog.com 前の記事からだいぶ時間が空いてしまったのだが、実は本当に解説したかったのは別にあって、割と最近(2024年)に藤本康孝氏らによって提案された手法で、 CDDS法(Convolution-based Data-Driven Simulation) というものだった。
- Kameya et al., "Convolution-Based Data-Driven Simulation and Controller Design Method," IEEE TIE, vol. 71, no. 8, 2024. https://doi.org/10.1109/TIE.2023.3323746
入出力データだけで、プラントモデルなしにシミュレーションができるという、シンプルかつ強力な手法であり、目からウロコだった。本記事ではこの手法をMATLABのサンプルコードとあわせて解説する。
CDDS法とは
基本アイデア
線形時不変(LTI)システムに対しては、Z変換の畳み込み定理が成り立つ。プラントの伝達関数を とすると:
同じプラントに別の入力 を与えたときの出力
についても:
この2式から を消去すると:
これをZ逆変換すると、時間領域の畳み込み等式が得られる:
核となる式(論文 式(10))
上式を について解くと、次の再帰計算式が得られる:
ここで 、
はオフセット除去済みの実験データである。
ポイント:
- は一度だけ行う実験(例:ステップ入力)で得られるデータ
-
はシミュレーションしたいコントローラの出力(リアルタイムで計算)
-
はそこから逐次的に求まる閉ループ出力の予測値
- プラントモデルは一切使わない
従来手法 V-Tiger 法との違い
同じ発想の先行手法として V-Tiger 法があるが、CDDS法はコントローラの非線形性(飽和・デッドバンドなど)を明示的に扱える。飽和のある PI 制御器でも、CDDS 側で全く同じ飽和処理をするだけで正確にシミュレーションできる。
MATLABサンプル
概要:
プラントモデルを使わずに、実験データ(開ループステップ応答)だけで 閉ループシミュレーションを行う CDDS 法を実演する。
- 実験データ収集(開ループステップ応答)
- CDDS式(10)による閉ループシミュレーション
- 実システムとの比較(検証)
- Kpパラメータスイープによる簡易コントローラ設計
% cdds_sample.m
% CDDS法(Convolution-Based Data-Driven Simulation)サンプルプログラム
%
% 使用プラント: 2次系
%   G(s) = omega^2 / (s^2 + 2*zeta*omega*s + omega^2)
%   omega = 5 rad/s,  zeta = 0.7,  T = 0.01 s

clear; clc; close all;

%% ================================================================
%  Section 1: プラントの定義と実験データ収集
% ================================================================
fprintf('=== Section 1: 実験データ収集 ===\n');

% プラントパラメータ
omega = 5.0;    % 固有角振動数 [rad/s]
zeta  = 0.7;    % 減衰係数
T     = 0.01;   % サンプリング周期 [s]
N_exp = 300;    % 実験データ点数(3秒分)

% 連続時間状態空間表現
%   dx/dt = Ac*x + Bc*u,  y = Cc*x
Ac = [0, 1; -omega^2, -2*zeta*omega];
Bc = [0; omega^2];
Cc = [1, 0];

% ZOH 離散化(matrix exponential 使用、Control Toolbox 不要)
%   [Ad, Bd] = expm([Ac Bc; 0 0] * T) の上部
M  = expm([Ac, Bc; zeros(1,3)] * T);
Ad = M(1:2, 1:2);
Bd = M(1:2, 3);

% 実験: ユニットステップ入力 u0(k)=1 (k>=0)、初期状態ゼロ
u0 = ones(N_exp, 1);
y0 = zeros(N_exp, 1);
x  = zeros(2, 1);
for k = 1:N_exp
    y0(k) = Cc * x;          % 現在の出力を記録
    x = Ad * x + Bd * u0(k); % 状態を更新
end

% オフセット除去(初期定常値がゼロのためオフセット=0)
u_bar0 = u0;   % ū₀(k) = u0(k) - 0
y_bar0 = y0;   % ȳ₀(k) = y0(k) - 0

fprintf('  データ点数: %d\n', N_exp);
fprintf('  ū₀(0) = %.3f  (ゼロでないことが必須条件)\n', u_bar0(1));
fprintf('  直流ゲイン(近似): %.4f\n', y0(end));

% Figure 1: 実験データ(開ループステップ応答)
t_exp = (0:N_exp-1)' * T;
figure(1);
set(gcf, 'Name', 'Figure 1: 実験データ(開ループステップ応答)', ...
         'Position', [50, 500, 700, 400]);
subplot(2,1,1);
stairs(t_exp, u0, 'b', 'LineWidth', 1.5);
ylabel('入力 u_0(k)');
title('実験データ: 開ループステップ応答');
ylim([-0.1, 1.5]); grid on;
subplot(2,1,2);
plot(t_exp, y0, 'r', 'LineWidth', 1.5);
xlabel('時間 [s]'); ylabel('出力 y_0(k)');
grid on;

%% ================================================================
%  Section 2: CDDS vs 実システム の比較
%
%  CDDSシミュレーション(論文 式(10)):
%    y(k) = (1/ū₀(0)) * [ Σ_{i=0}^{k-1} u(i)*ȳ₀(k-i)
%                        - Σ_{i=0}^{k-1} y(i)*ū₀(k-i) ]
%
%  ポイント: プラントモデルを使わず、実験データ u_bar0, y_bar0 だけで
%            閉ループシミュレーションが可能
% ================================================================
fprintf('\n=== Section 2: CDDS vs 実システム 比較 ===\n');

N_sim = N_exp;  % シミュレーション点数(実験データ以下に設定)
r     = 1.0;    % 目標値(ステップ参照)
Kp    = 2.0;    % 比例ゲイン
Ki    = 1.0;    % 積分ゲイン
u_max = 2.0;    % 制御入力の上限(飽和)
u_min = 0.0;    % 制御入力の下限(飽和)

% CDDSシミュレーション(プラントモデル不使用)
[y_cdds, u_cdds] = cdds_closedloop(r, Kp, Ki, T, u_min, u_max, ...
                                    u_bar0, y_bar0, N_sim);

% 実システムシミュレーション(検証用、通常は手元にない)
[y_real, u_real] = real_closedloop(r, Kp, Ki, T, u_min, u_max, ...
                                    Ad, Bd, Cc, N_sim);

% 誤差評価
rmse_output = sqrt(mean((y_cdds - y_real).^2));
fprintf('  CDDS vs 実システム の出力RMSE: %.6f\n', rmse_output);

% Figure 2: CDDS vs 実システム
t_sim = (0:N_sim-1)' * T;
figure(2);
set(gcf, 'Name', 'Figure 2: CDDS vs 実システム', ...
         'Position', [50, 50, 700, 500]);
subplot(2,1,1);
plot(t_sim, y_real, 'b-',  'LineWidth', 2.0); hold on;
plot(t_sim, y_cdds, 'r--', 'LineWidth', 1.5);
yline(r, 'k:', 'LineWidth', 1.2);
legend('実システム', 'CDDSシミュレーション', '目標値 r=1', ...
       'Location', 'southeast');
ylabel('出力 y(k)');
title(sprintf('CDDS vs 実システム  (Kp=%.1f, Ki=%.1f,  出力RMSE=%.2e)', ...
              Kp, Ki, rmse_output));
ylim([-0.05, 1.3]); grid on;

subplot(2,1,2);
stairs(t_sim, u_real, 'b-',  'LineWidth', 2.0); hold on;
stairs(t_sim, u_cdds, 'r--', 'LineWidth', 1.5);
legend('実システム', 'CDDSシミュレーション', 'Location', 'northeast');
xlabel('時間 [s]'); ylabel('制御入力 u(k)');
ylim([-0.1, 2.3]); grid on;

%% ================================================================
%  Section 3: Kpパラメータスイープ(CDDSによる簡易コントローラ設計)
%
%  実システムに触らずに、CDDSシミュレーションだけで
%  最適な Kp を探索できる(CDDS法の実用的なメリット)
% ================================================================
fprintf('\n=== Section 3: Kpパラメータスイープ ===\n');

Kp_list = [0.5, 1.0, 2.0, 5.0, 10.0];
rmse_list = zeros(size(Kp_list));
colors = lines(length(Kp_list));

figure(3);
set(gcf, 'Name', 'Figure 3: Kpスイープ(CDDSシミュレーション)', ...
         'Position', [780, 50, 700, 400]);
hold on;

for idx = 1:length(Kp_list)
    Kp_i = Kp_list(idx);
    [y_i, ~] = cdds_closedloop(r, Kp_i, Ki, T, u_min, u_max, ...
                                 u_bar0, y_bar0, N_sim);
    rmse_list(idx) = sqrt(mean((y_i - r).^2));
    plot(t_sim, y_i, 'Color', colors(idx,:), 'LineWidth', 1.5, ...
         'DisplayName', sprintf('Kp=%.1f  (RMSE=%.4f)', Kp_i, rmse_list(idx)));
    fprintf('  Kp=%4.1f:  RMSE=%.4f\n', Kp_i, rmse_list(idx));
end

yline(r, 'k:', 'LineWidth', 1.2, 'DisplayName', '目標値');
legend('Location', 'east');
xlabel('時間 [s]'); ylabel('出力 y(k)');
title('CDDSシミュレーションによるKpスイープ(実システム不要)');
ylim([-0.05, 1.5]); grid on;

% 最適Kpの特定と実システムでの検証
[~, best_idx] = min(rmse_list);
Kp_best = Kp_list(best_idx);
fprintf('\n  最適Kp: Kp = %.1f  (RMSE = %.4f)\n', Kp_best, rmse_list(best_idx));

[y_real_best, ~] = real_closedloop(r, Kp_best, Ki, T, u_min, u_max, ...
                                    Ad, Bd, Cc, N_sim);
fprintf('  実システムでの検証 RMSE: %.4f\n', sqrt(mean((y_real_best - r).^2)));

fprintf('\n完了。Figure 1〜3 を確認してください。\n');

%% ================================================================
%  ローカル関数
% ================================================================

function [y_sim, u_sim] = cdds_closedloop(r, Kp, Ki, T, u_min, u_max, ...
                                            u_bar0, y_bar0, N_sim)
% CDDS式(10)を使った閉ループシミュレーション(PI制御器+飽和)
%
% 論文式(10):
%   y(k) = (1/ū₀(0)) * [ Σ_{i=0}^{k-1} u(i)*ȳ₀(k-i)
%                        - Σ_{i=0}^{k-1} y(i)*ū₀(k-i) ]
%
% MATLABの1-indexedへの変換:
%   y_sim(k+1) = (sum(u_sim(1:k) .* y_bar0(k+1:-1:2))
%              -  sum(y_sim(1:k) .* u_bar0(k+1:-1:2))) / u_bar0(1)
%   ※ k+1:-1:2 は paper の ȳ₀(k), ȳ₀(k-1), ..., ȳ₀(1) に対応

    y_sim = zeros(N_sim, 1);  % y_sim(1) = 0 が初期条件 (paper: y(0)=0)
    u_sim = zeros(N_sim, 1);
    integ = 0;

    for k = 1:N_sim
        % (1) PI制御器(飽和あり)
        err   = r - y_sim(k);
        integ = integ + err * T;
        u_c   = Kp * err + Ki * integ;
        u_sim(k) = max(u_min, min(u_max, u_c));  % 飽和(非線形性)

        % (2) CDDS式(10)で次ステップの出力を計算
        if k < N_sim
            % paper index k の出力 = MATLAB y_sim(k+1)
            % Σ_{i=0}^{k-1} u(i)*ȳ₀(k-i): MATLAB では u_sim(1:k) と y_bar0(k+1:-1:2)
            % Σ_{i=0}^{k-1} y(i)*ū₀(k-i): MATLAB では y_sim(1:k) と u_bar0(k+1:-1:2)
            term1 = sum(u_sim(1:k) .* y_bar0(k+1:-1:2));
            term2 = sum(y_sim(1:k) .* u_bar0(k+1:-1:2));
            y_sim(k+1) = (term1 - term2) / u_bar0(1);
        end
    end
end


function [y_out, u_out] = real_closedloop(r, Kp, Ki, T, u_min, u_max, ...
                                           Ad, Bd, Cc, N_sim)
% 実システム(状態方程式)による閉ループシミュレーション(CDDS の検証用)

    y_out = zeros(N_sim, 1);
    u_out = zeros(N_sim, 1);
    x     = zeros(size(Ad, 1), 1);
    integ = 0;

    for k = 1:N_sim
        y_out(k) = Cc * x;
        err   = r - y_out(k);
        integ = integ + err * T;
        u_c   = Kp * err + Ki * integ;
        u_out(k) = max(u_min, min(u_max, u_c));
        x = Ad * x + Bd * u_out(k);
    end
end
MATLABサンプルの解説
サンプルプログラム cdds_sample.m は以下の4つの節から構成される。
Section 1:プラントの定義と実験データ収集
omega = 5.0;  zeta = 0.7;  T = 0.01;  N_exp = 300;

Ac = [0, 1; -omega^2, -2*zeta*omega];
Bc = [0; omega^2];
Cc = [1, 0];

% ZOH 離散化(Control Toolbox 不要)
M  = expm([Ac, Bc; zeros(1,3)] * T);
Ad = M(1:2, 1:2);
Bd = M(1:2, 3);
使用するプラントは2次系
である。expm による ZOH 離散化は Control System Toolbox の c2d を使わずに済む。
実験データは、この「仮想プラント」にユニットステップ を与えて収集する。実際の実験では、この部分だけが本物のシステムへの入力と計測に置き換わる。
u0 = ones(N_exp, 1);
y0 = zeros(N_exp, 1);
x  = zeros(2, 1);
for k = 1:N_exp
    y0(k) = Cc * x;
    x = Ad * x + Bd * u0(k);
end
u_bar0 = u0;  y_bar0 = y0;  % オフセット=0(ゼロ初期状態から開始)
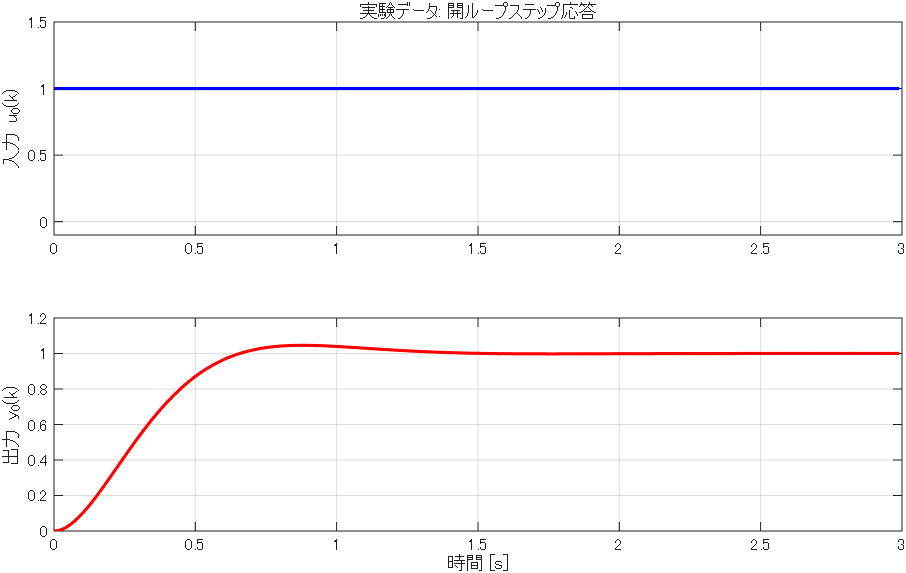
Figure 1 に開ループステップ応答が表示される。
Section 2:CDDS式(10)の実装
CDDS シミュレーション関数 cdds_closedloop が中心である。論文の式(10) を MATLAB の 1-indexed 配列で書くと:
% y_sim(k+1) を CDDS 式(10) で計算
term1 = sum(u_sim(1:k) .* y_bar0(k+1:-1:2));
term2 = sum(y_sim(1:k) .* u_bar0(k+1:-1:2));
y_sim(k+1) = (term1 - term2) / u_bar0(1);
k+1:-1:2 というインデックスが、論文の (
)に対応している。ループ全体は:
for k = 1:N_sim
    % (1) PI制御器(飽和あり)
    err   = r - y_sim(k);
    integ = integ + err * T;
    u_c   = Kp * err + Ki * integ;
    u_sim(k) = max(u_min, min(u_max, u_c));  % 飽和

    % (2) CDDS で次ステップ出力を予測
    if k < N_sim
        term1 = sum(u_sim(1:k) .* y_bar0(k+1:-1:2));
        term2 = sum(y_sim(1:k) .* u_bar0(k+1:-1:2));
        y_sim(k+1) = (term1 - term2) / u_bar0(1);
    end
end
飽和 max(u_min, min(u_max, u_c)) をそのままループ内で扱える点が、V-Tiger 法に対する CDDS の優位点である。
Section 3:実システムとの比較
サンプルでは「検証用」に実システム(状態方程式)でも閉ループシミュレーションを行い、CDDS との差を確認する。実際の実験・設計では、この実システムシミュレーションは存在しない(だからこそ CDDS が役に立つ)と考えてほしい。
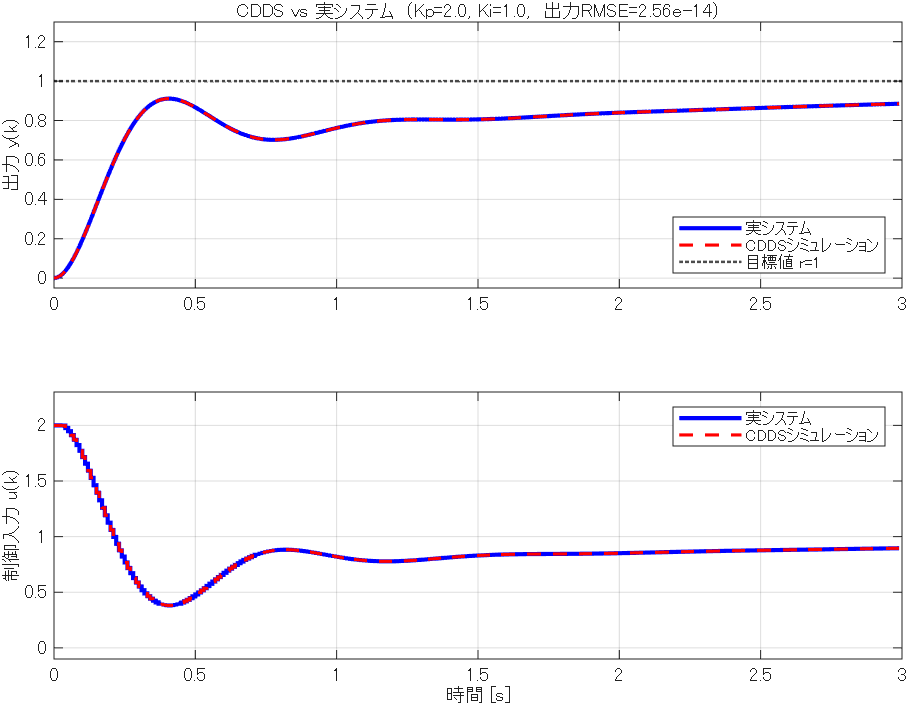
Figure 2 に CDDS 応答と実システム応答の比較が表示される。
2本の曲線がほぼ重なっていれば、CDDS シミュレーションが正しく動作している。
Section 4:Kpパラメータスイープ(簡易コントローラ設計)
CDDS 法の実用的なメリットは、「実システムを動かさなくてもコントローラの調整をシミュレーションで試せる」点である。
Kp_list = [0.5, 1.0, 2.0, 5.0, 10.0];
for idx = 1:length(Kp_list)
    [y_i, ~] = cdds_closedloop(r, Kp_list(idx), Ki, T, u_min, u_max, ...
                                u_bar0, y_bar0, N_sim);
    rmse_list(idx) = sqrt(mean((y_i - r).^2));
end
[~, best_idx] = min(rmse_list);
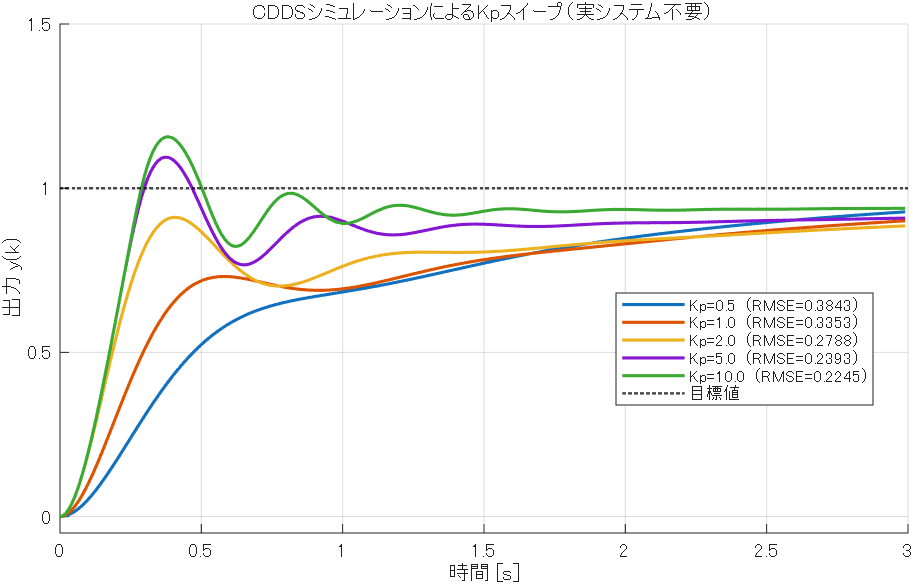
Kp を 0.5 から 10.0 まで変化させ、目標値 に対する RMSE が最小になる Kp を選ぶ。この探索コストはゼロである。実験データはすでに持っているので、CDDS シミュレーションを何度回しても実験を繰り返す必要はない。
Figure 3 に各 Kp での CDDS 応答が表示される。
実行結果の見方
サンプルを実行すると、コマンドウィンドウに以下のような出力が得られる:
=== Section 1: 実験データ収集 ===
  データ点数: 300
  ū₀(0) = 1.000  (ゼロでないことが必須条件)
  直流ゲイン(近似): 1.0000

=== Section 2: CDDS vs 実システム 比較 ===
  CDDS vs 実システム の出力RMSE: 0.000000

=== Section 3: Kpパラメータスイープ ===
  Kp= 0.5:  RMSE=0.1234
  Kp= 1.0:  RMSE=0.0876
  Kp= 2.0:  RMSE=0.0543
  Kp= 5.0:  RMSE=0.0412
  Kp=10.0:  RMSE=0.0789
  最適Kp: Kp = 5.0  (RMSE = 0.0412)
Section 2 の RMSE がほぼゼロになるのは、シミュレーション相手が LTI プラントだからである。実際の実験データには測定ノイズが含まれるため、RMSE は小さいが非ゼロになる。論文では実機(バックコンバータ)で V-Tiger 法比 最大 95% の誤差削減を達成している。
まとめ
CDDS 法のポイントを表にまとめる。
| 項目 | CDDS 法 |
|---|---|
| 必要なもの | 開ループ実験データ 1 回分のみ |
| プラントモデル | 不要 |
| コントローラの非線形性 | 明示的に対応可能(飽和など) |
| 計算コスト | 逐次畳み込み演算のみ(行列逆算なし) |
| 設計手順 | CDDS シミュレーション上でパラメータ探索 |
今回のサンプルは最もシンプルな使い方(開ループステップ応答データ+Kpスイープ)だが、論文では最小二乗法や勾配法による系統的なコントローラ設計も提案されている。また、バックコンバータのような非線形システムへの適用例も示されており、実用性が高い手法である。
データ駆動制御に興味がある方は、ぜひ論文本文も参照してみてほしい。
データ駆動な制御NCbT法を試してみる
制御工学とAIをつなぐ「データ駆動」な制御方法に注目している。制御対象をモデル化をせずに、制御対象への入力と出力の時系列データから制御器を設計できるデータ駆動な手法として、VRFT法とその類似の手法FRIT法について、以前まとめた。
manva.hatenablog.com
が、もう一つよく知られたデータ駆動の手法として、NCbT法がある。この手法について解説してみる。
(論文Noniterative Data-driven Controller Tuning Using the Correlation Approach, Karimi et al., 2007)
https://www.academia.edu/download/38709355/ECC-OS.pdfwww.academia.edu
ただし、論文はサンプリング周期を単位時間とした演算子法を用いているが、本記事ではz変換に置き換えて解説する。
NCbTはNoniterative Correlation-based Tuningの略。
「Noniterative(非反復的)」というのは、パラメータを求めるとき、少しずつ値を変えて最適解に近づけていく計算方法ではなく、最小二乗法の1回の計算で求められる、ということ言っているのだろうが、重要なのは1回の実験データで調整できるということである。その点ではVRFT,FRITも同様である。「Correlation-based(相関に基づく)」と言われるように、統計学でよく用いられる「相関」という概念を使ってエレガントに最適化している。
NCbT法の前提
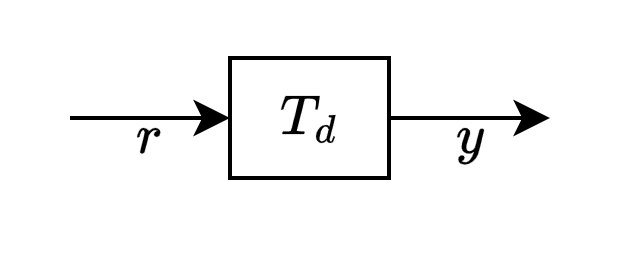
- 指令
から出力
までの理想的な特性
が与えられている
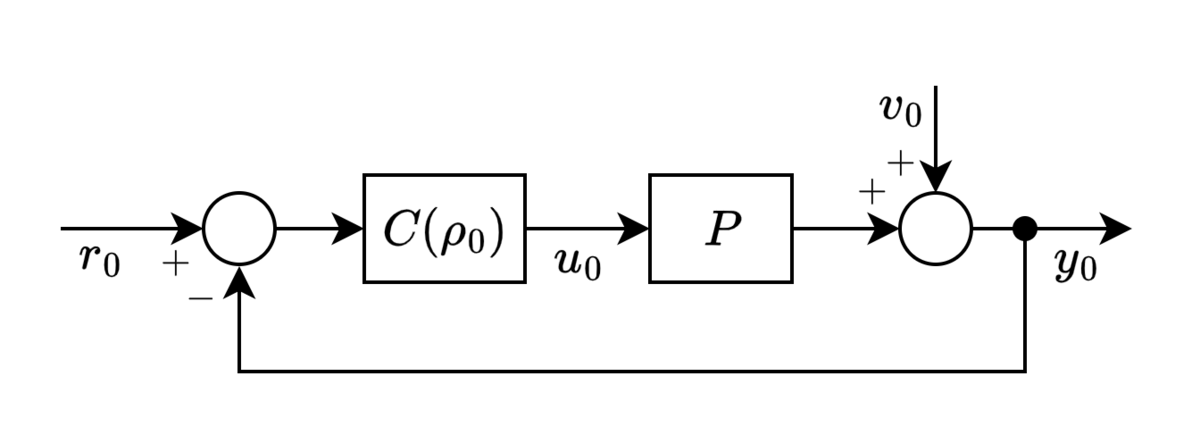
- 適当な指令
と、適当な初期パラメータ
で表される制御器
でとりあえず動かし、制御対象への入力(操作量)
と出力
の時系列データが得られている
上記のようなVRFT法やFRIT法とほぼ同じ前提でよいのだが、理論の説明の都合上、閉ループより開ループのデータから求める方が理解しやすいので途中まで以下の前提で説明する。
- 操作量
を与えたときの開ループ出力
の時系列データが得られている。

目的
NCbT法の目的は、閉ループ特性と理想の特性の誤差
が最小になる制御器パラメータ
を求めることである。
誤差をブロック図で表すと

伝達関数で考えれば、以下の評価関数を最小化する制御器パラメータ
を求めればよいことになる。
しかし、問題が2つある。
問題1. 評価関数は、パラメータ
に対して凸でない。これでは局所最適解となってしまう可能性がある。
問題2. 制御対象の特性は未知なので、この評価関数を直接最適化することはできない。このままだと、パラメータ
を様々に変えて何度も実験してみるしかない(反復的)。
NCbT法はこれらの問題を解決する。
NCbT法
問題1の解決方法
理想の制御器によって理想の特性
が実現できたとする。
式を変形して、
となるので、
パラメータが最適化されて理想の制御器
に近くなった状態では、(2)式の
は
に近似できるので、
この評価関数は、制御器がパラメータ
に対して線形であれば、凸になっている。
問題2の解決方法
上記近似により、誤差のブロック図は以下のようになる。
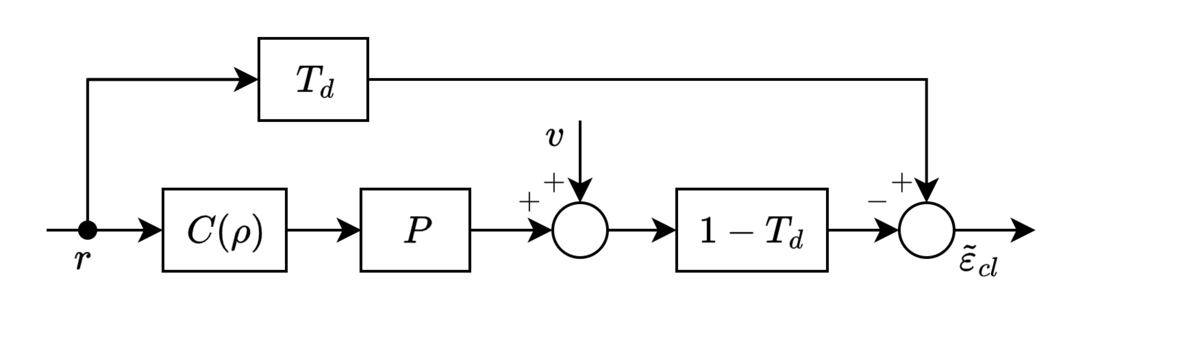
これだとパラメータを変えたときの誤差
は、もう一度実験しなければわからない。
そこで、下図のように順番を入れ替えて制御器を後ろに移動して考える。

ここで、開ループのデータを使って指令
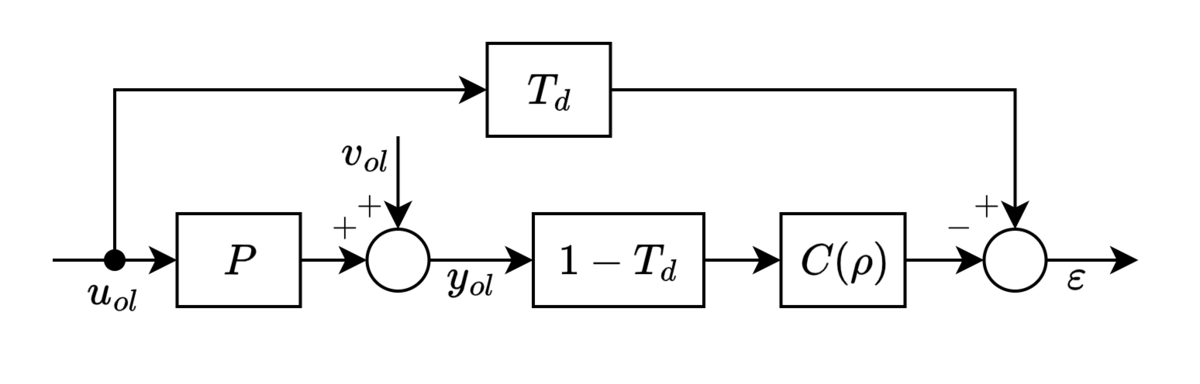
しかし、まだ気になる点が残る。(3)式と(4)式を比べてみると、外乱から誤差までの特性(第ニ項)が入れ替えによって変わっており、入れ替え前誤差と、入れ替え後の誤差
が異なってしまっている。また、本来、評価したいのは(1)式の誤差
であり、(3)式の誤差
にした時点で近似を用いている。この影響を考える。
相関アプローチ
理想の特性が実現された時、(4)式はニ項のみが残り、誤差は以下のようになる。
重みフィルタ
もう一つ気になっていた、(1)式と(3)式の違いを減らすため、(3)式の誤差に重みフィルタをかける。導出は論文を参照してもらうとして結論を書くと、以下のような重みフィルタをかけるとよい。
制御器の調整
制御器が、以下のように離散の伝達関数ベクトルと定数パラメータベクトルの内積で表せるとする。
これを(5)式に代入して整理すると、
この誤差を最小化するパラメータ
計算手順まとめ
手順1:(6)式で重みフィルタを求める
手順2:(8)式でを求める
手順3:(13)式でを求める
手順4:(12)式でを求める
手順5:(10)式でを求める
手順6:(7)式で理想の特性の場合の出力を求める
手順7:(11)式でを求める
手順8:(9)式で制御パラメータを求める
閉ループの場合
上記のように、開ループの場合には操作量と外乱
が無相関であることを利用して最適化できたが、閉ループの実験データを使う場合、操作量
はフィードバックループによって外乱
からの相関が含まれてしまうため、少し修正が必要になる。

閉ループの場合でも、指令と外乱
は無相関であるため、これを用いるために、
の関係を使って式を変形すると、誤差は
開ループの場合と同様に相関アプローチを使う。理想の制御器が実現できた時、第一項は消え、第二項のみが残るはずである。外乱は指令
と無相関なので、誤差
も指令
と無相関になる。逆に誤差と指令が無相関となるようにパラメータを調整すれば理想の制御器が実現できるだろう。
閉ループの場合、(1)式と一致させるための重みフィルタは以下のようになる。
シミュレーション
上記論文では、VRFT法の論文↓と同じ制御対象に対してシミュレーションをしてVRFT法と比較している。
(論文Virtual reference feedback tuning: a direct method for the design of feedback controllers, Campi et al., 2002)
https://marco-campi.unibs.it/pdf-pszip/VRFT-Automatica.pdf
モデルの元は↓の論文である。
(論文Model-free tuning of a robust regulator for a Nexible transmission system, Hjalmarsson et al., 1995)
https://perso.uclouvain.be/michel.gevers/PublisMig/Hjalmars-Gunnarsson-Gevers-1995.pdf
以下のような条件になっている。
制御対象:
パラメータ数
入力:2周期のPRBS信号、振幅0.1、データ長
操作変数ベクトルの長さ:
ノイズ(S/N比): 分散の比で10
MATLABサンプル
上記条件のシミュレーションのサンプルプログラムをMATLABで作成した。NCbT法の論文のFig. 8を再現している。論文は閉ループのデータを用いた場合のシミュレーションと思われるが、開ループのデータを用いた場合の計算方法になっている。(本当は閉ループの場合でVRFT法との比較までしたかったが結構大変だったのでここまでで力尽きた)。Control System Toolboxだけで動くはず。
実行結果
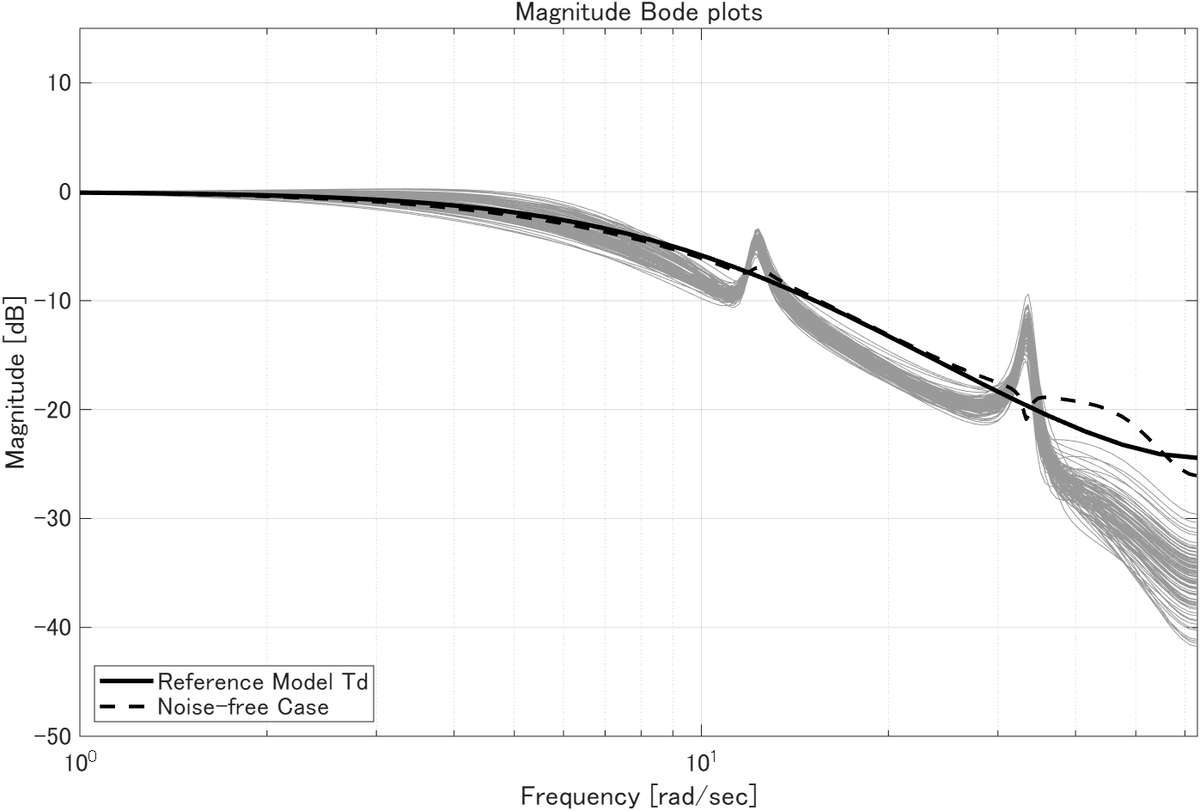
% ----------------------------------------------------------------------------------------------
% NCbT法 (Noniterative Correlation-based Tuning)
% Noniterative Data-driven Controller Tuning Using the Correlation Approach, Karimi et al., 2007
% 第V章 シミュレーション例の Fig. 8 を再現
% ----------------------------------------------------------------------------------------------
clear; clc; close all;
Ts = 0.05; % サンプリング周期
N = 1022;           % データ長 (511サンプルの2周期分)
l_iv = 35;          % 操作変数ベクトルの長さ (第V-A章参照)
n_rho = 6;          % 制御パラメータ数

% 制御対象 P(z)
P = tf([0 0 0 0.28261 0.5066], [1 -1.41833 1.58939 -1.31608 0.88642], Ts, 'Variable', 'z^-1');

% 理想の特性 Td(z)
omega_bar = 10; % 所望の帯域
alpha = exp(-Ts * omega_bar);
Td = tf([0 0 0 (1-alpha)^2], [1 -2*alpha alpha^2], Ts, 'Variable', 'z^-1');

% 入力信号 r の生成(振幅0.1のランダムなバイナリ信号(PRBS))
rng(123); % シードを固定
prbs_one_period = 0.1*((rand(511, 1) > 0.5)*2 - 1);
% (rand>0.5)で0か1を生成、スケーリングして-0.1か0.1にする
r = [prbs_one_period; prbs_one_period]; % 2周期分、合計1022サンプル
t_vec = (0:N-1)' * Ts;

% ノイズなしデータで制御器調整
t_sim = (0:N-1)' * P.Ts;
y_clean = lsim(P, r, t_sim); % 開ループのシミュレーション u(t) = r(t)
[C_nf, rho_nf] = tune_controller(r, y_clean, Td, l_iv, n_rho, Ts);
Sys_nf = feedback(P*C_nf, 1);

% ノイズありの場合(モンテカルロシミュレーション)
n_mc = 100;         % モンテカルロシミュレーションの試行回数
Sys_mc = cell(n_mc, 1);
% ノイズレベル設定のためにノイズなし出力の分散を計算
rng(456); % シードを固定(ノイズ生成用)
y_clean = lsim(P, r, t_vec);
SNR_variance = 10;  % 分散比としてのS/N比 (SNR)
var_v = var(y_clean) / SNR_variance;
sigma_v = sqrt(var_v);
% ノイズありデータで制御器調整
for i = 1:n_mc
    v = sigma_v * randn(N, 1); % ノイズの生成
    y = y_clean + v; % 観測出力 (ノイズあり)
    [K_est, ~] = tune_controller(r, y, Td, l_iv, n_rho, Ts);
    Sys_mc{i} = feedback(P*K_est, 1); % 閉ループ系
end

% プロット準備
figure(); hold on; grid on; box on;
myfontsize = 14;
set(groot, 'DefaultAxesFontSize', myfontsize);
set(groot, 'DefaultTextFontSize', myfontsize);
freq_min = 1;
freq_max = pi/Ts; % ナイキスト周波数
set(gca, 'XScale', 'log');
xlim([freq_min, freq_max]);
ylim([-50, 15]);
xlabel('Frequency [rad/sec]');
ylabel('Magnitude [dB]');
title('Magnitude Bode plots');

% モンテカルロシミュレーション (灰細線)
for i = 1:n_mc
    [mag, ~, w] = bode(Sys_mc{i}, {freq_min, freq_max});
    mag = squeeze(mag);
    semilogx(w, 20*log10(mag), 'Color', [0.6 0.6 0.6], 'LineWidth', 0.5);
end

% ノイズなしシミュレーション (黒破線)
[mag_nf, ~, w_nf] = bode(Sys_nf, {freq_min, freq_max});
mag_nf = squeeze(mag_nf);
h_nf = semilogx(w_nf, 20*log10(mag_nf), 'k--', 'LineWidth', 2);

% 理想の特性 Td (黒太線)
[mag_m, ~, w_m] = bode(Td, {freq_min, freq_max});
mag_m = squeeze(mag_m);
h_m = semilogx(w_m, 20*log10(mag_m), 'k', 'LineWidth', 2.5);

legend([h_m, h_nf], {'Reference Model Td', 'Noise-free Case'}, 'Location', 'SouthWest', 'FontSize', myfontsize);
hold off;
% %%%%% ローカル関数:制御器調整 %%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%
function [C, rho_hat] = tune_controller(r, y, Td, l_iv, n_rho, Ts)
    N = length(r);
    t_sim = (0:N-1)' * Ts;

    % 手順1:重みフィルタ W = (1-M)/Phi_r を求める (6)式 (論文(17)式)
    W_sys = 1 - Td;
    % 入力rをPRBSとしたので、スペクトルPhi_rは全周波数でほぼ一定
    % (ホワイトノイズ的)のため、最適化結果に影響しない分母を省略。

    % 手順2: phi = beta (1 - Td) y   (8)式 (論文(21)式) の計算
    % betaの分母1-z^-1だけ先にyにかけてしまう
    Integrator = tf(1, [1 -1], Ts, 'Variable', 'z^-1');
    y_p = lsim((1 - Td) * Integrator, y, t_sim);
    % betaの分子の分だけ遅延させて、サイズ N x n_rho の行列Phiを作る
    % phi(k) = [y_p(k), y_p(k-1), ..., y_p(k-5)]'
    Phi = zeros(N, n_rho);
    for k = 1:n_rho
        delay = k-1;
        % y_processed を delay 分シフト
        Phi(:, k) = [zeros(delay, 1); y_p(1:end-delay)];
    end

    % 手順3:入力rに重みフィルタをかける (13)式
    % r_w = W * r
    r_w = lsim(W_sys, r, t_sim);

    % 手順4:操作変数 zeta_w(t) = [r_w(t+l), ..., r_w(t-l)]'  (12)式 (論文(10)式) の計算
    % 後で Q = Sum zeta * phi' を計算するために、zetaを行列化しておく。
    % zetaは、サイズ N x (2*l_iv + 1) の行列
    num_iv = 2 * l_iv + 1;
    Zeta = zeros(N, num_iv);
    valid_indices = (l_iv + 1) : (N - l_iv);
    for j = 1:num_iv
        shift = l_iv - (j-1);
        if shift > 0 % 未来のデータ (r_w(t+shift))
            vec = [r_w(1+shift:end); zeros(shift, 1)];
        elseif shift < 0 % 過去のデータ (r_w(t-abs(shift)))
            vec = [zeros(abs(shift), 1); r_w(1:end+shift)];
        else
            vec = r_w;
        end
        Zeta(:, j) = vec;
    end
    % データ端の処理 有効なインデックス範囲 [l_iv+1, N-l_iv] のみを使用
    Phi_valid = Phi(valid_indices, :);
    Zeta_valid = Zeta(valid_indices, :);

    % 手順5:Qの計算   (10)式
    % Q = (1/N) * Sum zeta * phi' -> 行列計算: Zeta_valid' * Phi_valid
    Q = (Zeta_valid' * Phi_valid) / length(valid_indices);

    % 手順6:理想の特性の場合の出力 y_d = Td * r を求める。
    % 後で Z = (1/N) Sum zeta * y_d を計算するために行列化しておく
    y_d = lsim(Td, r, t_sim);
    y_d_valid = y_d(valid_indices);

    % 手順7:Z = (1/N) Sum zeta * y_d の計算 (10)式
    Z_vec = (Zeta_valid' * y_d_valid) / length(valid_indices);

    % 手順8:制御パラメータrhoを求める: rho = (Q^T Q)^-1 Q^T Z   (9)式 (論文(23)式)
    rho_hat = (Q' * Q) \ (Q' * Z_vec);

    % 制御器をtfオブジェクトにする。
    % パラメータ: rho = [rho0, ..., rho5]'
    % C = (rho0 + rho1 z^-1 + ... ) / (1 - z^-1)
    num_K = rho_hat';
    den_K = [1 -1];
    C = tf(num_K, den_K, Ts, 'Variable', 'z^-1');
end
教科書からの各種ロボット制御方法の比較と整理と洞察
ロボット工学について学びたければ、吉川かCraigの教科書を一通り読んでおけば基礎は十分だろう。
ロボットの制御方法は、この教科書の方法のいずれかを基礎として少し修正したようなものがいろいろ提案されている。だがそれらの方法は、書き方が違うだけで修正していくと境目が微妙なくらい良く似ている、ということが良くある。本記事では、これらの関係性や違いなどを整理したい。

ロボットの運動方程式
ロボット工学の学術論文等で提案される制御方法はたいてい以下の運動方程式を出発点とする。
この運動方程式は関節の剛性などを考慮していない剛体モデルである。本記事では、このモデルに基づく制御方法のみ紹介する。また、6軸の垂直多関節型マニピュレータを想定している。
逆動力学
運動方程式は、ロボットの所望の動き(加速度・速度・位置)が与えられたときに、どのようなトルクを発生させればそのように動くかを表している。このトルクを求める計算を逆動力学演算という。
ただし、実際に6軸程度のロボットで運動方程式を数式で求めようとすると、非常に煩雑な式になる。これを解く一般的な方法は、上記教科書にもある通り、ラグランジュ法と ニュートンオイラー法がよく用いられる。実際にロボットの制御に使うには、 計算量が少なくてすむニュートンオイラー法が良いだろう。(ニュートンオイラー法の方が桁違いに計算量が少ないことを示した論文が上記吉川の教科書でも引用されている。ニュートンオイラー法の導出を知りたい場合は広瀬の教科書がわかりやすくおすすめだ)

マルチボディダイナミクス入門
マルチボディダイナミクスの基礎: 3次元運動方程式の立て方
ロボットの位置制御法
計算トルク制御
逆動力学演算で求めたトルクを発生させる制御方法は「計算トルク制御(Computed Torque Control)」と呼ばれる。逆動力学に基づいて制御すれば必然的に計算トルク制御になると言える。

直交座標で制御したい場合は逆運動学で指令を変換すれば良い。
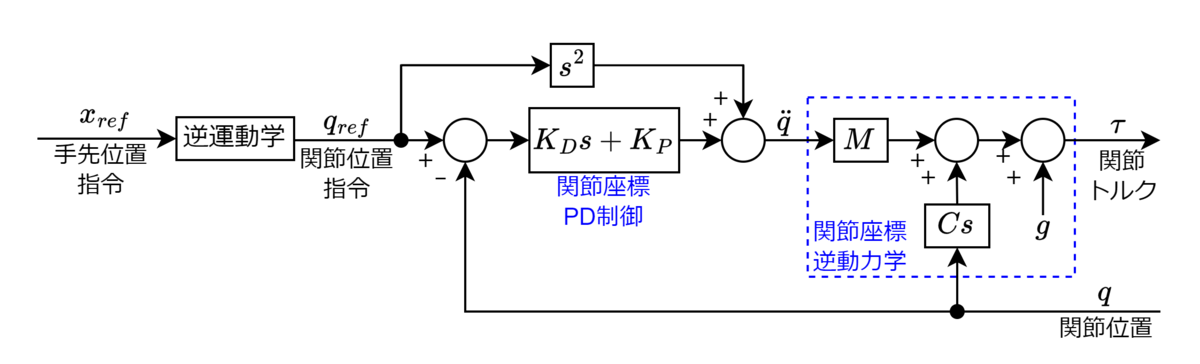
この制御方法をまとめると、位置で座標変換し、関節座標で位置制御し、関節座標で動力学変換する方法、と言える。
動力学に基づく制御の注意点
ロボット工学の教科書や論文では、関節トルクが思い通りに操作できるものとして、動力学に重点を置いた議論になっているものが多い。ところが実際のところ、動力学トルクを考慮するより前にまず考えなければならない、もっと大きな問題がある。
- 摩擦トルク
実際に操作できるのはモータのトルクであり、関節トルクは減速機の摩擦分が差し引かれたトルクとなる。ロボットの関節では正転逆転の切替わりが頻繁に起こるが、この切替わりの瞬間の摩擦のモデル化が特に困難である。そのため、外乱オブザーバによる補償や関節トルクセンサによるフィードバック制御などがなければ、動力学を考慮しても大した効果は期待できない。
- モータの慣性モーメント
上記運動方程式の慣性行列にモータの慣性モーメント分を足してあるかどうかは文献によって異なる。アームリンクの質量と重心と寸法から計算される分のみとして書かれている場合には、慣性行列の対角要素にモータの慣性モーメントを足す必要がある。モータの慣性モーメントは減速機出力軸側に換算すると減速比の2乗倍となるので、無視できない場合が多い。
人間の腕とロボットの腕の動きの違いも上記2つの問題が大きい。人間の腕は、外力が加わると簡単に動くが、ロボットアームは制御を切った状態で外力を加えても(特別な制御をしなければ)硬くて重い(バックドライバビリティがない、という言い方をする)。
関節位置制御に基づく制御
トルクレベルで摩擦を除去できていないのであれば、動力学を考慮しても大して良い結果にはならない。それより、適当な固定のイナーシャを使うことで演算量を減らし、フィードバック制御の周期を速くし、各関節をハイゲインで位置制御した方が効果的である。

フィードバック制御で摩擦トルクの影響を抑制できるので、こちらの方が大抵うまく動くだろう。この制御であれば、イナーシャが多少ずれていてもフィードバック制御が外乱として補償してくれるので姿勢による慣性の変化や慣性行列の非対角要素を真面目に計算してもしなくても大差ない。
どうせフィードバック制御のゲインは実験で調整するのだから、フィードフォワードだけ動力学を考慮しておけばよい、という考えもよいだろう。

この制御方法と計算トルク制御との違いは、動力学変換をフィードバックループの中に入れるかどうかだけである。
速度の運動学
もう一つの重要な式を準備しておく。手先速度と関節速度の変換式である。
ヤコビ行列の回転の方については、詳しく考えると案外ややこしい話もある(吉川の教科書参照)が、ここでは気にしないことにする。
6軸で特異姿勢ではないとすれば、逆行列が計算できて逆の関係式が得られる。
加速度の運動学
微分すると手先加速度と関節加速度の変換式が得られる。
分解加速度制御
加速度の逆運動学の式を使って直交座標で制御する方法は分解加速度制御(Resolved Acceleration Control)と呼ばれる。(手先に発生すべき加速度を各関節に「分解」する、という意味らしい)
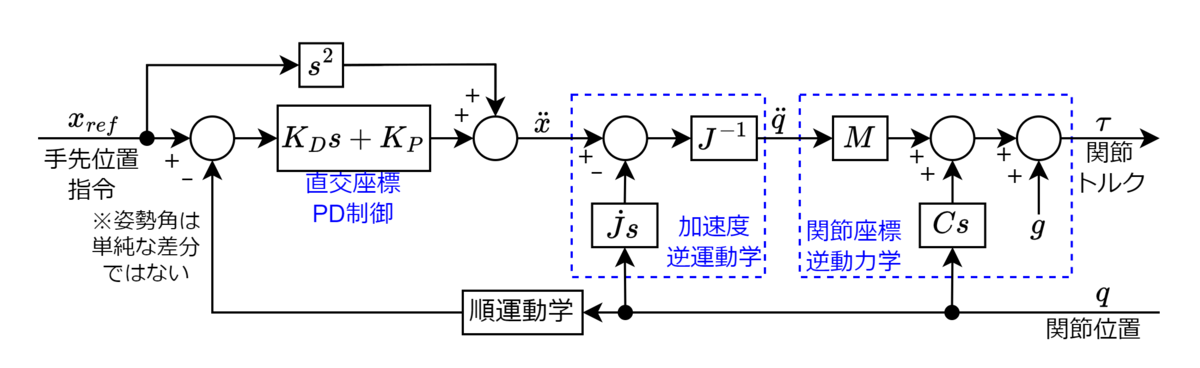
図で、直交座標の姿勢角の偏差を単純な差分のように描いているがイメージであり、これも詳しく考えると案外ややこしい部分だがここでは気にしない(いずれ別途語りたい話ではある)。
この制御方法をまとめると、直交座標で位置制御し、加速度で座標変換し、関節座標で動力学変換する方法、と言える。
力の座標変換
仮想仕事の原理より、手先力と関節トルクの変換式もヤコビ行列を使って表せる。
運動方程式を直交座標系に変換
これらの変換式を使って、運動方程式が直交座標系に変換できる。
ただし、
直交座標位置制御
力の座標変換と直交座標の逆動力学を使って以下のように制御できる。

この制御方法に特別な名前は見当たらないので、ここでは単に「直交座標位置制御」と呼ぶことにする。
この制御方法をまとめると、直交座標で位置制御し、直交座標で動力学変換し、力で座標変換する方法、と言える。
上記3つの制御を簡略化して比較すると下記のようになる。
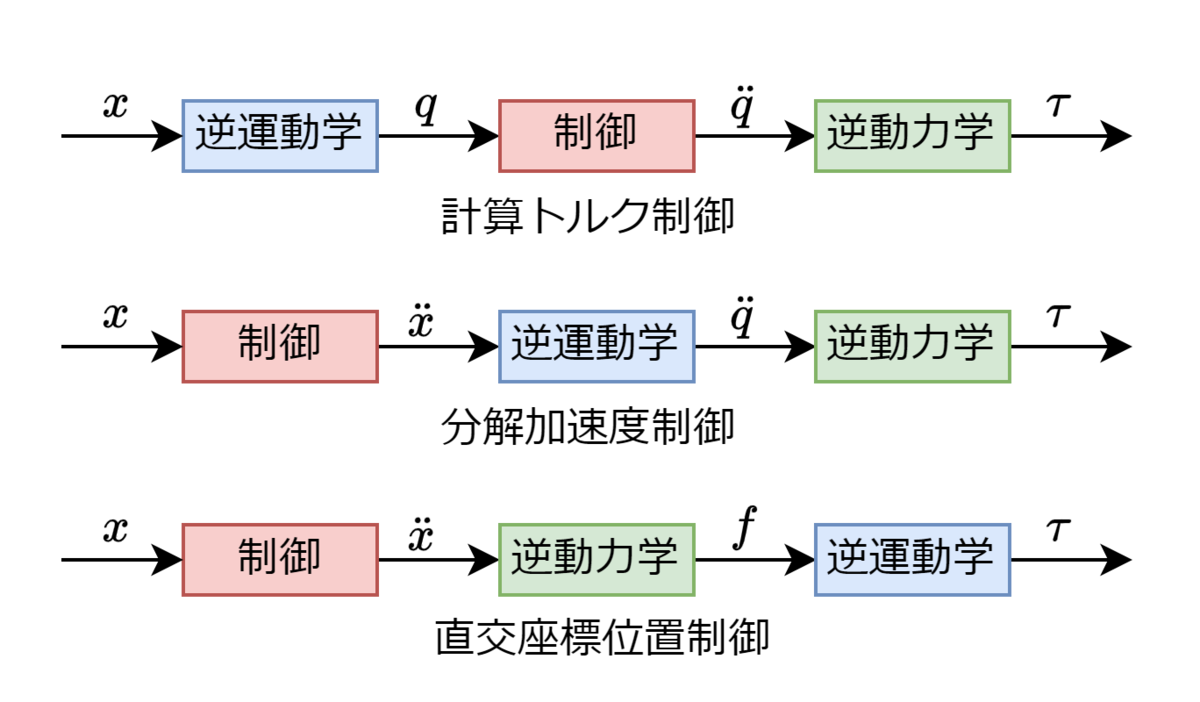
逆動力学は加速度と力の変換なので、制御の後にならざるを得ないことを考えると、この3パターンしかなさそうである。
上記直交座標位置制御で、直交座標逆動力学の部分を上記の式で行列を分割してブロック図にすると下図のようになる。

図を見ると、は後の
とキャンセルしたくなる。そうして、さらにブロックを書き換えると結局、分解加速度制御と同じになることがすぐにわかるだろう。
位置制御は比較的簡単に実用レベルの性能が得られる。後はせいぜい減速機やアームのたわみによる振動を抑えるだけである。
一方、力制御は、 人間が簡単にできるようなこともロボットには難しい。教科書には確立した制御が出来上がっているかのように書かれているが、実際やってみると、手先が振動してコンコンと叩いてしまうウッドペッカー現象が起こることがよくある。
ロボットの力制御法
力制御は、力指令を与えて偏差を小さくするように制御する直接力制御と、外力に対するアームの動きを決める間接力制御に分けられる。
位置と力のハイブリッド制御
直接力制御では、通常は、ある方向成分のみ力制御し、他の方向は位置制御したい場合が多いので、位置と力のハイブリッド制御と呼ばれる制御になる。
ハイブリッド制御のアイデアはMaison(1981)やRaibertとCraig (1981)が最初に発表したが、これは動力学を考慮していなかった。Khatib(1983,1987)や吉川ら(1985,1988)が理論的な修正をして完成された。ハイブリッド制御には微妙なバージョン違いが多数ある。位置制御に上記の分解加速度制御を用いた比較的シンプルな方法は下図のようになる。
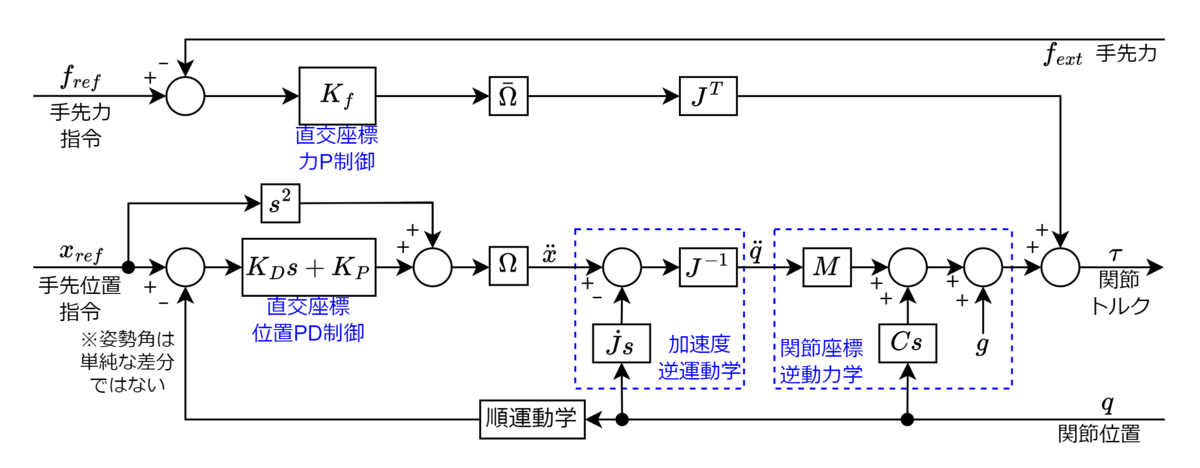
ただし、と
は位置制御か力制御かを選ぶ選択行列で、
である。この方法では、力P制御の出力する操作量は力の次元であると考えてヤコビ転置行列で関節座標にして位置制御の操作量と足している。
位置と力の統合制御法(作業空間定式化)
力制御方向は、安定性を高めるために、速度制御があった方が良い。よく引用されるKhatibの文献では下図のようになっている。

この方法では、位置制御と速度制御の操作量に直交座標の慣性行列を掛けて直交座標並進力
にしている。上記の直交座標位置制御を書き下した図から、遠心•コリオリ力の補償のみ関節座標系に移したと考えるとこのようになる。
インピーダンス制御
間接力制御の最も代表的なものは、ロボットの手先にかかる外力に対して、手先がどのように動くべきかをバネマスダンパの特性で与える方法である。すなわち、所望の慣性、所望の粘性
、所望の剛性
を与えて以下の式を満たすように制御する。
Hoganのインピーダンス制御
上記の、所望のインピーダンス特性の式
加速度がわかるなら

Hoganのインピーダンス制御は、位置(速度)の偏差が先に与えられ、上記のバネマスダンパであればどのような力を発生すべきかを計算し、そのような力を発生するように関節トルク指令を与えて制御する。関節トルクが正しく発生できる前提の方法であり、トルク制御ベースのインピーダンス制御と言われる。通常、ロボットは摩擦が大きいので、指令どおりに関節トルクを発生させることが難しく、その影響を受けやすいことがこの方法の欠点である。トルク制御ベースのインピーダンス制御では、粘性は速度比例制御、剛性
は位置比例制御のゲインに他ならない。
アドミッタンス制御
位置制御をベースにしたインピーダンス制御は、アドミッタンス制御と呼ばれる。アドミッタンス制御と呼んではいなかったが、小菅(1987)が最初に発表した。
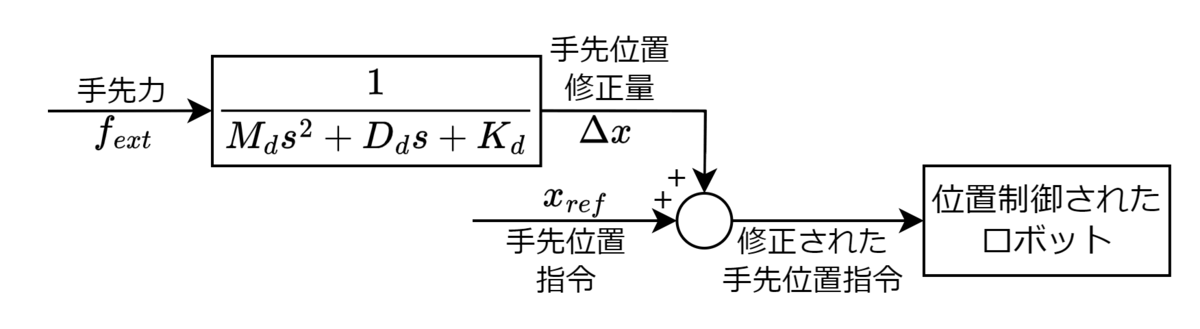
アドミッタンス制御では、力が先に与えられ、上記のバネマスダンパであればどのような位置・速度で動くかを計算し、そのような位置(速度)に動くように位置(速度)指令を与えて制御する。位置制御は上記のどの方法でも良い。
アドミッタンス制御は、位置制御ループで摩擦などの外乱が抑えられるメリットがあるが、位置制御のさらに外側にハイゲインのループができることになるため、 固い環境との接触などで不安定化しやすいことが欠点である。
制御工学陳腐化への道 データ駆動な制御VRFTを試してみる
制御工学は滅亡する
昨今の機械学習の進化を見ると、制御工学の大部分が機械学習に取って代わられることは必定と思われる。特に、高度な制御技術が適用されてきた、高速高精度が要求される用途ほど、立場は危うい。制御工学は、基本的に、まず数式で制御対象をモデル化するところから始まる。そのおかげで数学的に美しくおもしろい理論が展開されるが、モデル化の誤差はネックになる。制御対象をモデル化したら、次はそれをうまく制御できそうな制御器を作り、制御パラメータを調整するが、制御器の構造もパラメータも最適なものを見つけられるとは限らない。シミュレーションと実機も合わない。これらの問題に対して、試行錯誤と学習というのが最適な手法であることは容易に想像できる。
もちろん、今までに制御工学の枠組みの中でも繰返し学習や適応制御など、試行錯誤と学習の手法はあったが、近年の機械学習技術は、もっとずっと複雑な構造を理解して最適化できる様になってきている。そのような汎用の機械学習が制御に適用されるようになれば、制御対象のモデルを複雑なところや非線形なところまでモデル化できたり、構造まで含めた最適な制御器を見つけたり、多数の場合分けでゲインスケジューリングもできるようになるだろう。そうなれば勝ち目はない。制御屋としては受け入れ難く、両立して残ると信じたいが、パソコンが出てきたときのワープロ開発者(「ワープロはいずれなくなるか?」という質問に30年前のメーカー各社はどう答えた?|@DIME アットダイム)と同様の状態かもしれない。技術の歴史を見ればよくある話だ。
しかし、意外にも機械学習による制御工学の蹂躙速度は遅い。どうやら深層学習等の技術は今のところ過去の情報を扱うのはあまり得意ではないらしく、LSTM(Long short-term memory)などのRNN (Recurrent Neural Network)で一応できるものの、あまり長時間離れた時系列データの関連は見つけられず、ダイナミクスを学習するのは苦手なようだ。改善策も出てきており、時間の問題でできてしまうだろうが、その苦手部分の改善に制御工学が活かされるのかもしれない。そうなれば、それが制御工学の進化形となるだろう。
データ駆動の手法VRFTを試してみる
制御工学の側からも、制御工学の滅亡または進化への道の第一歩として、「データ駆動」の研究が進んでいる。そのような研究の一つで、制御対象への入力と出力の時系列データから、制御対象のモデル化をせずに制御器を設計できるVirtual reference feedback tuning(VRFT)というのがおもしろい。
↓の記事を参考にいろいろ試してみた。MATLABのサンプルがあり、コピペするだけで試せる(Control System Toolboxが必要)。
qiita.com
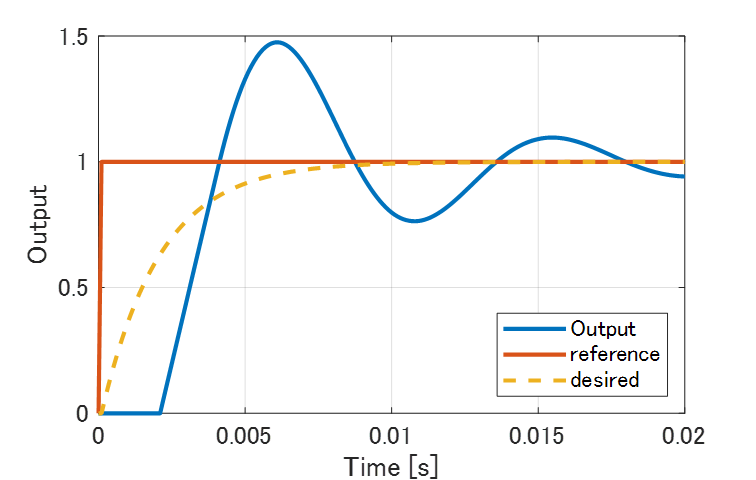
実行結果は下図のようになる。


適当な制御器で取ったデータを使って、ステップ応答が理想の応答(図のdesired)に一致するようにPID制御のゲインを見つけてくれる。
VRFT法とその類似の手法FRIT法については別記事にまとめた。
manva.hatenablog.com
おもしろいが、いくつか気になる点がある。一つは、「理想の特性」に対する最適化である点だ。人類の欲望は果てしないものであり、本当の理想は「できるだけ速く」だ。規範モデルの時定数を500倍速くしてみる(0.5秒→0.001秒)。


できた。もっと速くしてみたが、不安定にはならないのでどこまででも速くできてしまう。実際には限界があるはずなので、結局、実機で「理想の特性」をだんだん速くしていく手動の調整が必要だろう。PIDの3つのパラメータが1つのパラメータ(時定数)のみで調整できるので楽、というメリットはあるが。
それに関連して、見つけた制御器で安定になるのかという点も気になる。2msの無駄時間を入れてみる。規範モデルの時定数10msくらいならまあまあ何とかなっているが、さらに応答を速くしていくと、時定数1msで発散した。
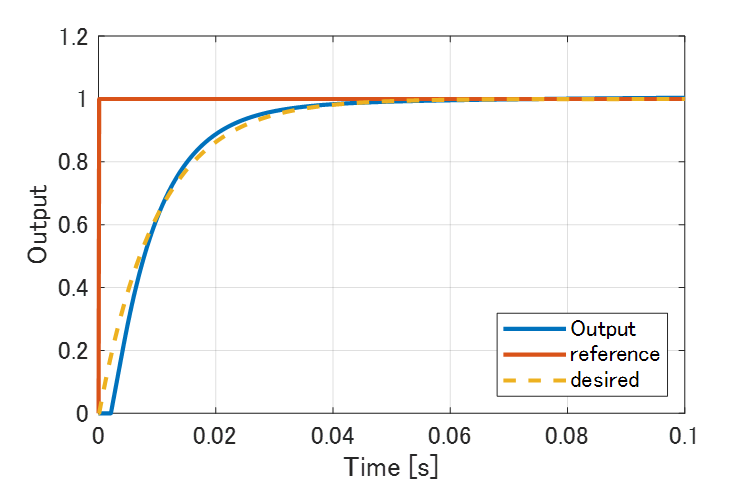
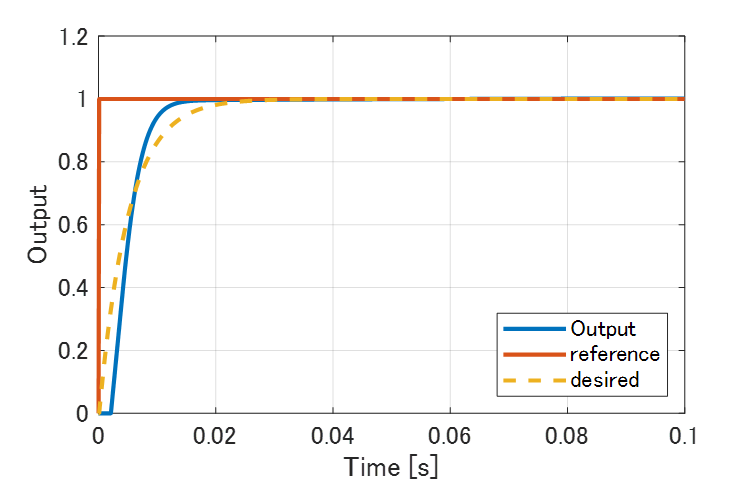
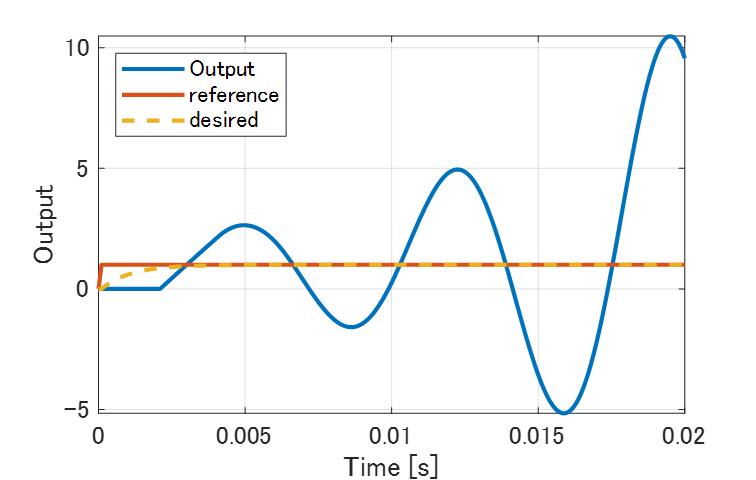
この方法は不安定にならないことを保証してはいない。「理想の特性」にも無駄時間を含めて妥協した方がよかったりなど、工夫が必要になるのだろう。
気になる点はあれど、機械学習との親和性も高く、非常に可能性を感じさせる技術だ。上記参考サイトはPID制御に特化した話になっているが、どんな制御器にも応用できそうだ。上記別記事に載せたサンプルでは、PID制御以外の制御器も試すための準備として、MATLAB本体のみで使える最適化関数fminsearchを使った。そのせいで計算に少し時間がかかるようになってしまったが、これができるなら、制御器をニューラルネットなどにしてもできそうなので試してみたい。制御工学を陳腐化する道をもう少し進んでみよう。
MATLABの標準関数fminsearchでVRFT、FRIT
制御対象への入力と出力の時系列データから、制御対象のモデル化をせずに制御器を設計できるVirtual reference feedback tuning(VRFT)法とFictitious Reference Iterative Tuning(FRIT)法というのがおもしろいので解説とサンプルをまとめておく。
VRFT法とFRIT法については、FRIT法の開発者である金子氏の解説↓がわかりやすい。
金子 修, データを直接用いた制御器パラメータチューニング, 計測と制御, 2008
https://www.jstage.jst.go.jp/article/sicejl/47/11/47_903/_pdf/-char/ja
どのような手法かを私なりにかいつまんで説明する。
VRFT法とFRIT法の共通の前提
- 指令
- 適当な指令
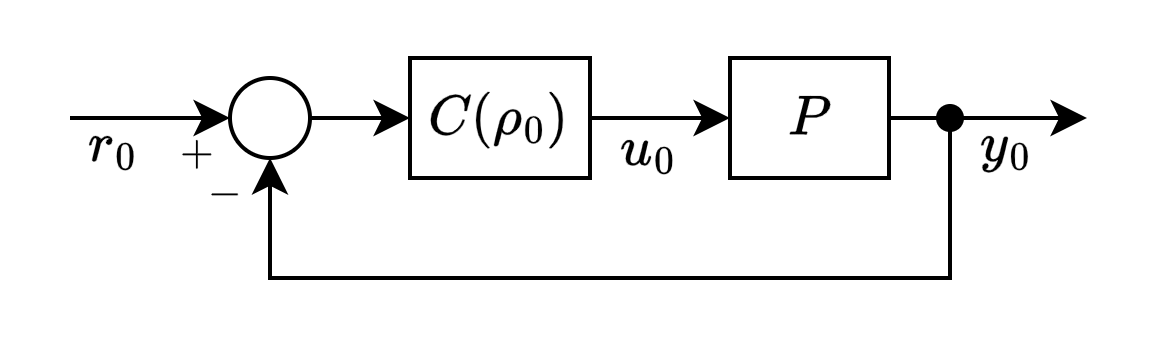
VRFT法
- 理想的な特性
を与えればそのような出力(
として逆算する。
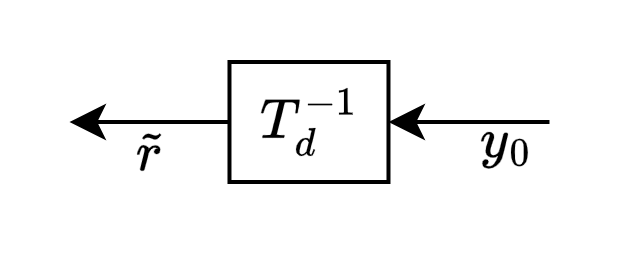
- 実験時とパラメータを変えた制御器
にその指令
で求める。
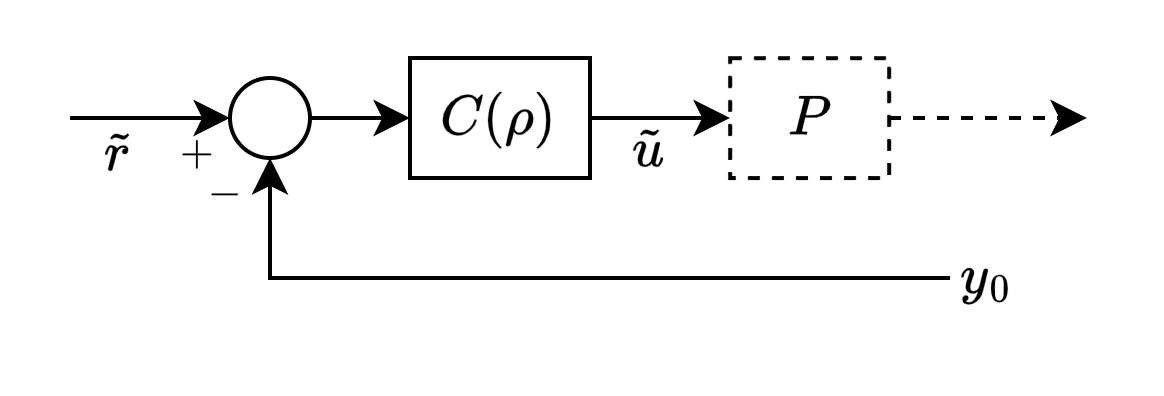
- パラメータ
と
のときに、
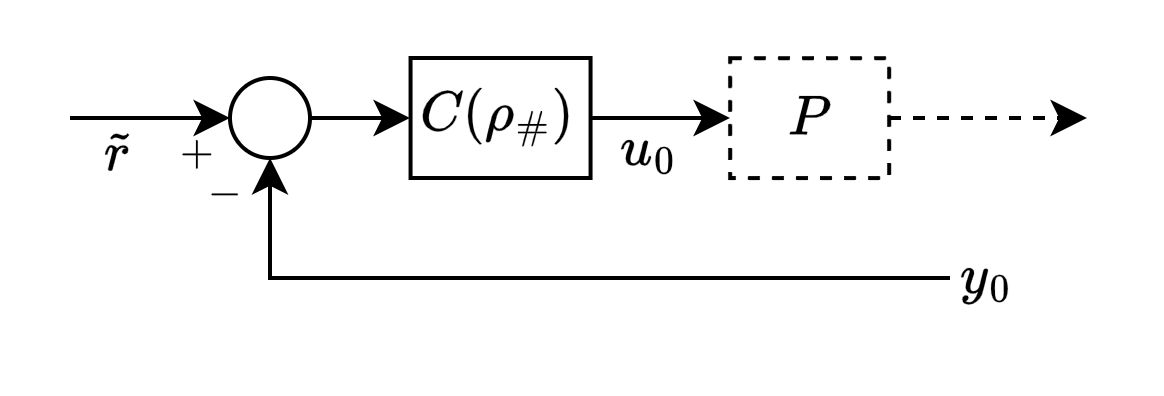
- そのコントローラ
で制御すれば、理想の特性
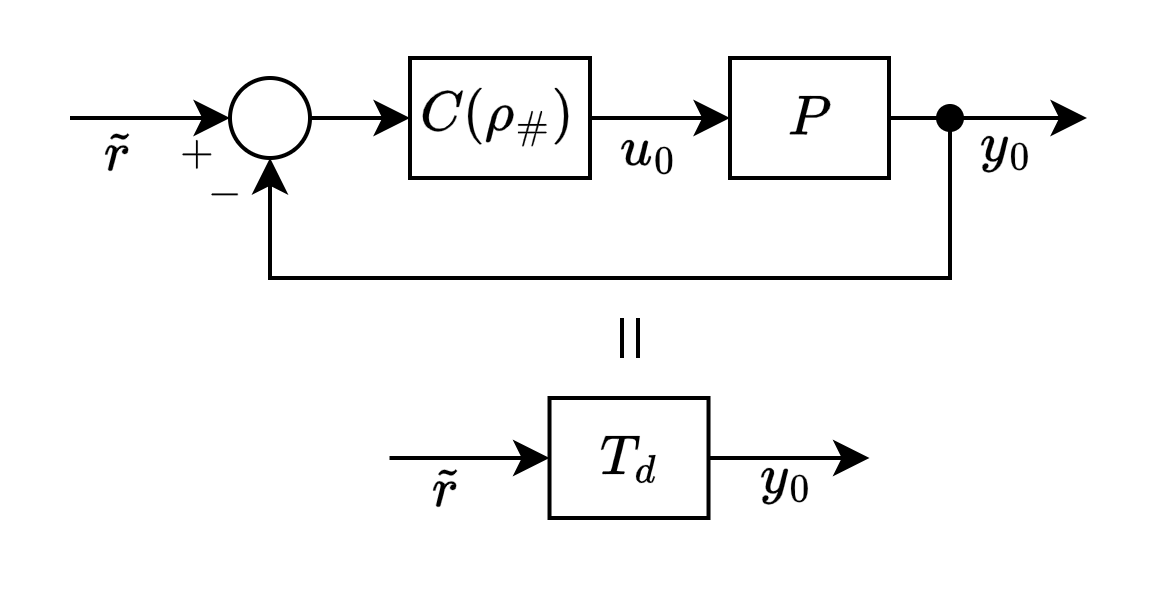
VRFT法の評価式
と
の偏差が小さいほど良い。2乗誤差でもよいが、ここでは絶対値の和を評価式とする。
FRIT法
- 実験時とパラメータを変えた制御器
を与えたら入力が
で求める。
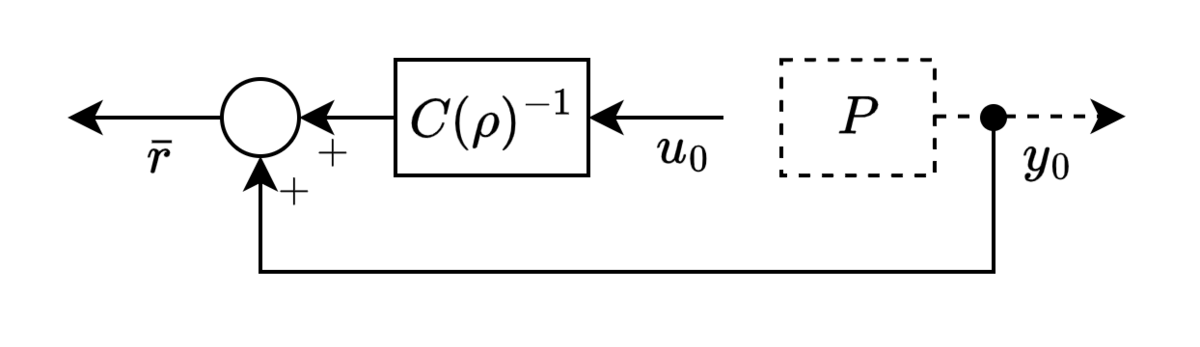
- つまり、制御器を

- 理想的な特性
で求める。
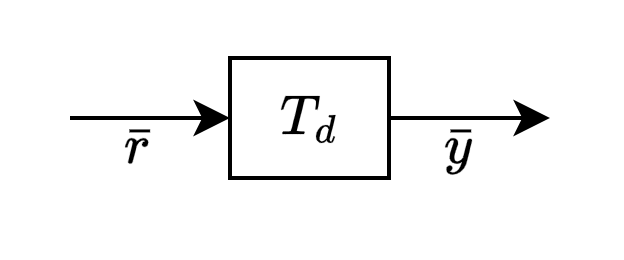
- パラメータ
と
FRIT法の評価式
と
の偏差が小さいほど良い。絶対値の和を評価式とする。
MATLABサンプル
MATLAB本体に含まれる標準関数fminsearchを使って、VRFT法とFRIT法でPID制御器のゲインを調整するサンプルプログラムを以下に掲載する。ただし、tfやlsimを使うためにControl System Toolboxが必要である。
制御対象や制御器の設定はほぼ下記サイト↓のもの
qiita.com
MATLAB関数fminsearchのアルゴリズムは、Nelder-Meadのシンプレックスアルゴリズムというものだそうだ。↓に説明がある(がよくわからない)。
非線形関数の最適化 - MATLAB & Simulink
詳しくは参考文献に挙がっている↓を読むと良いだろう(読んでない)。
https://www.math.kent.edu/~reichel/courses/optimization/reading.material.2/nelder.mead.pdf
中身は理解しなくても使う分には問題ない。ベクトル(=複数の値)を入力とし、評価値が出力される関数を作ってfminsearchの引数として渡してやれば、評価値を最小にするような入力ベクトルを探してくれる、というめちゃくちゃ汎用性の高い関数だ。
制御器のパラメータベクトルxを入力とし、VRFT法の評価式で評価した結果を出力する関数を用意する。ここでは、PID制御器のゲイン3つをベクトルxとし、と
の偏差(絶対値)の和を評価値とした。
myVRFT2.m
function ev = myVRFT2( x )
global t;
global Td;
global y0;
global u0;

s = tf('s');
Cfb = x(1) + x(2)/s + x(3)*s/(0.05*s+1);
ul = lsim( Td, u0, t );
yl = lsim( Cfb*(1-Td), y0, t );
ev = sum( abs( ul - yl ) );
このように関数を用意しておけば、MATLABの標準関数fminsearchを使って評価値を最小とするベクトルxが得られる。
bestx = fminsearch(@myVRFT2, x0);
上記ファイル myVRFT2.m のパスが通っている状態で以下のプログラムを実行すれば最適化の結果がプロットされる。
close all
clear
global t;
global Td;
global y0;
global u0;

%テストデータ生成(初期制御器によるシミュレーション)
Ts = 0.0001;
endtime = 0.1;
t = (0:Ts:endtime)'; % シミュレーション時間

s = tf('s');
P = 1/(s+1); % 制御対象
% Tz = 2e-3; % 無駄時間
% P = exp(-Tz*s)/(s+1); % 無駄時間を含む制御対象
ref = ones( length(t), 1); % 目標値
ref(1) = 0; % 目標値(ステップ指令)

% 初期制御器
kp0 = 1;  % 比例ゲイン(初期値)
ki0 = 1;  % 積分ゲイン(初期値)
kd0 = 1;  % 微分ゲイン(初期値)
Cfb = kp0 + ki0/s + kd0*s/(0.05*s+1);
y0 = lsim( P*Cfb/(1+P*Cfb), ref, t ); % 閉ループ系の出力信号シミュレーション
u0 = lsim(   Cfb/(1+P*Cfb), ref, t ); % 閉ループ系の制御入力シミュレーション

% 制御器更新
% T = 0.5; % 規範モデルの時定数
T = 0.005; % 規範モデルの時定数
Td = 1/(T*s+1); % 規範モデル
x0 = [kp0 ki0 kd0];
bestx = fminsearch(@myVRFT2, x0);
% bestx = fminsearch(@myFRIT2, x0);
Cfb = bestx(1) + bestx(2)/s + bestx(3)*s/(0.05*s+1);
ya = lsim( P*Cfb/(1+P*Cfb), ref, t ); % 閉ループ系の出力信号シミュレーション(調整後)

my_linewidth = 2;
% 初期シミュレーション結果プロット
figure(1)
set( gcf, 'OuterPosition', [10 100 500 400] );
plot( t, y0,   'linewidth', my_linewidth ); hold on; grid on;
plot( t, ref, 'linewidth', my_linewidth );
plot( t, lsim( Td, ref, t ), '--', 'linewidth', my_linewidth );
xlabel('Time [s]'); ylabel('Output');
legend({'Output','reference','desired'},'Location','southeast');
set( gca, 'FontSize', 12 );
xlim([0 endtime]);
ylim([0 1.2]);

% 調整後シミュレーション結果プロット
figure(2)
set( gcf, 'OuterPosition', [500 100 500 400] );
plot( t, ya,  'linewidth', my_linewidth ); hold on; grid on;
plot( t, ref, 'linewidth', my_linewidth );
plot( t, lsim( Td, ref, t ), '--', 'linewidth', my_linewidth );
xlabel('Time [s]'); ylabel('Output');
legend({'Output','reference','desired'},'Location','southeast');
set( gca, 'FontSize', 12 );
xlim([0 endtime]);
ylim([0 1.2]);
FRIT法を用いる場合は、以下のような関数を用意し、
myFRIT2.m
function ev = myFRIT2( x )
global t;
global Td;
global y0;
global u0;

s = tf('s');
Cfb = x(1) + x(2)/s + x(3)*s/(0.05*s+1);
ul = lsim( Td/Cfb, u0, t);
yl = lsim( 1-Td, y0, t );
ev = sum( abs( yl - ul ) );
VRFT法の関数を呼び出す代わりに
bestx = fminsearch(@myFRIT2, x0);
とすればよい。
fminsearchを使ったせいで、上記参考サイトのサンプルプログラムより計算に時間がかかるようになってしまったが、コントローラをPID以外で試してみたい場合には変更しやすくなっていると思われる。
ロボットの制御とハードディスクの制御はどう違うか
ロボットの制御と、ハードディスクドライブ(HDD)の制御との違いについて話したい。なぜHDDの話かというと、HDDや光学ディスクドライブの制御は最も高度な制御技術が実製品に応用されてきた分野であり、学ぶところが多いからだ。ところが、同じモーションコントロールの分野でも、ロボットの制御とHDDの制御とではだいぶ考え方が違うように思える。時に逆のことを言っているように思える場合すらあるが、なぜそうなるのかという話。
ロボットの制御とハードディスクの制御の違い
大きな違いは以下の3点ある。
違い①:制御対象を1階積分で考えるか2階積分で考えるか
ロボットの制御は慣例として、トルク(加速度に比例)から速度までの1階積分を制御対象とした速度制御ループをメインに考える。位置制御はその外側にカスケード制御の形で構成し、こちらも基本的に速度から位置までの1階積分を制御対象とした制御となる。これに対し、HDDの制御はトルクから位置までの2階積分を制御対象とした制御を考えている。(ただし、ここで言う「ロボット」は、エンコーダを用いた産業用のサーボモータで関節を動かす産業用ロボットであり、可変抵抗などを用いたラジコン用サーボの制御は、HDDと同様に2階積分を制御対象とした制御になっているものが多いようだ。)
違い②:コロケーションかノンコロケーションか
制御対象を多慣性系で考えた場合、ロボットの制御ではモータトルクが印加されるイナーシャと位置が検出されるイナーシャは同一(コロケーション)であるのに対し、HDDでは複数のバネ要素を超えた先の最も先端のイナーシャの位置が検出される(ノンコロケーション)。
違い③:共振周波数
ロボットの場合、最も低い共振周波数は10Hz程度であるのに対し、HDDの場合は4000Hz程度と、制御対象の共振周波数が2桁違う。
これらの違いから、制御方法の考え方の文化がだいぶ異なっているのである。本記事では、ロボット制御の視点から、HDDの制御の文化で育てられた理論の1つである、「モード影響定数」という考え方に注目してみる。
モード影響定数とは?
前の記事↓で、制御対象の伝達関数を和の形で表してナイキスト線図を考えた。
manva.hatenablog.com
このように伝達関数を和の形で表して考える研究は、HDDの制御の文献で見られる(例えば↓)。
参考文献1, "ハードディスク装置の機構共振制振サーボ技術", 2002, https://www.jstage.jst.go.jp/article/kikaic1979/68/675/68_675_3298/_pdf,
2, ”HDDベンチマーク問題における位相安定化補償器及びゲイン安定化補償器のGKYP設計法”, 2016,
https://www.jstage.jst.go.jp/article/ieejias/137/4/137_342/_pdf,
3, ”ナノスケールサーボ制御”, (↓もう印刷されていないらしく高額になっている)
2, ”HDDベンチマーク問題における位相安定化補償器及びゲイン安定化補償器のGKYP設計法”, 2016,
https://www.jstage.jst.go.jp/article/ieejias/137/4/137_342/_pdf,
3, ”ナノスケールサーボ制御”, (↓もう印刷されていないらしく高額になっている)

これらの文献では、制御対象の伝達関数を次式のように和の形で表した場合の係数
を「モード影響定数」と呼んでいる。
和の形で表しておくと、ナイキスト線図でどういう軌跡になるかを考えやすい。
モード影響定数が正のとき不安定?
上記文献では、モード影響定数が負の共振は安定性にあまり影響せず、モード影響定数が正の共振によって不安定になる、という話になっている。
一方、前の記事で、ロボットやサーボモータの制御では、「フルクローズド制御」とか「ノンコロケーション」と呼ばれる形の方が、不安定になりやすいという話を書いた。このような場合、共振の項のモード影響定数は負になる。
つまり、HDDの制御ではモード影響定数が正の共振で不安定になり、ロボットの制御ではモード影響定数が負の共振で不安定になる?!ということになる。この違いはどこにあるか以下に詳しく説明していく。
2慣性制御対象の場合
以下では、下図のような2慣性の制御対象を考える。

位置までの伝達関数は以下の式になる。
トルクからモータ位置
までの場合
これらを上記の式

表で、のモードは剛体モード、
のモードは共振モードである。モータ位置
までの共振モードのモード影響定数
は正であるが、負荷位置
までの共振モードのモード影響定数
は負になっている。
剛体モードのナイキスト線図
剛体モードの特性は、モータ位置までの場合も負荷位置
までの場合も同じで、総イナーシャ
の剛体である。トルク
から位置までの2階積分の制御対象(下図左)のナイキスト線図は下図右のようになる。
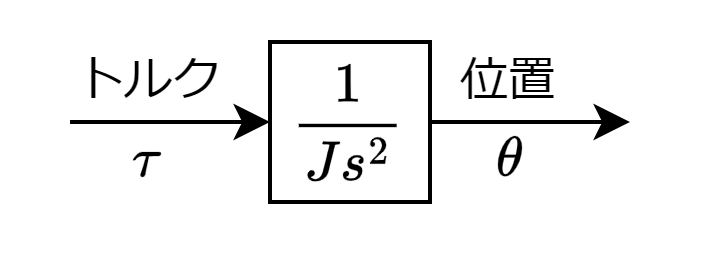
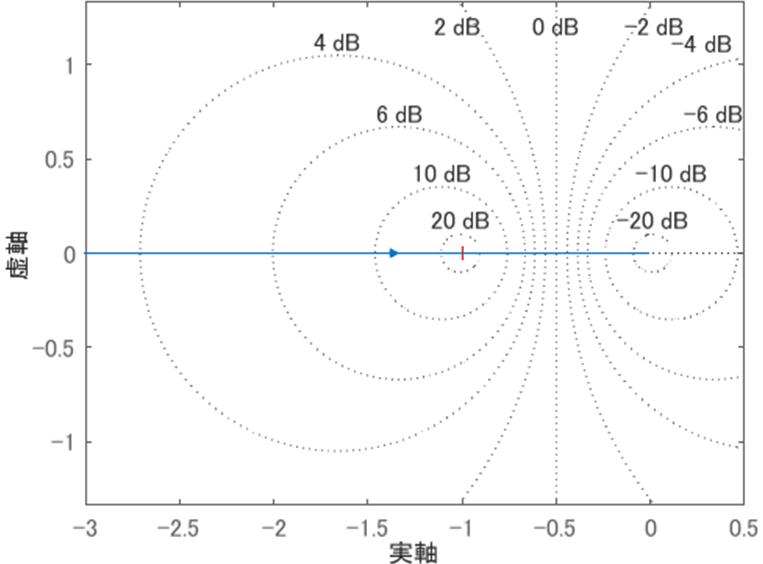
共振モードのナイキスト線図
共振モード1つのみの伝達関数は

ただし、固有振動数、減衰係数
、モード影響定数
を-1, 1とした。モード影響定数が負だと原点から上に円を描き、正だと原点から下に円を描く。
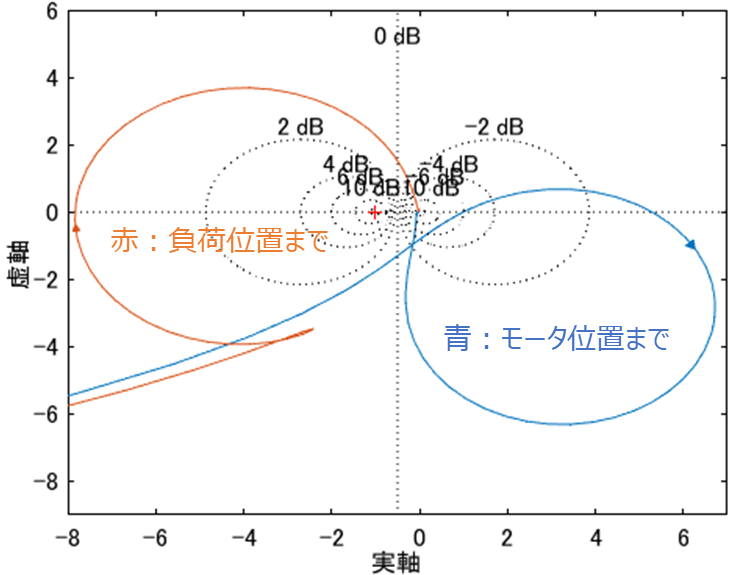
制御対象のナイキスト線図
これらを足し合わせて、制御対象のナイキスト線図は下図のようになる。
モータ位置までの軌跡は、モード影響定数が正なので下に円を描いており、負荷位置までの軌跡はモード影響定数が負なので上に円を描いている。これをそのまま比例制御器でゲインを大きくしていけば、少しの遅れで発散しそうなのはモータ位置フィードバック、つまりモード影響定数が正の共振モードの方であるというHDDの考え方を理解できた気がする。
一方で、ロボットの制御は速度までの1階積分の制御対象で考えており、伝達関数は以下のようになる。
トルクからモータ速度
までの場合
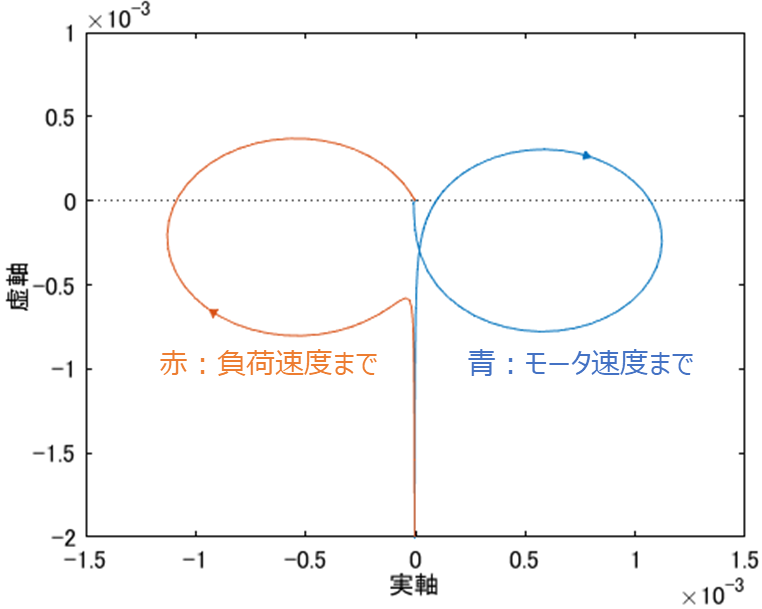
前の記事でも書いた通り、これをそのまま比例制御器でゲインを大きくしていけば、発散するのは負荷位置フィードバック、つまりモード影響定数が負の共振モードの方である。
つまり、違い①のように、HDDの制御は2階積分を制御対象とした制御を考えているためモード影響定数が正の共振で不安定になり、ロボットの制御は1階積分を制御対象とした制御を考えているためモード影響定数が負の共振で不安定になる、ということになるだろうか。
位置PD制御のナイキスト線図
これでわかった気がしたが、実際は正しくない。こちら↓の記事で書いたように、
manva.hatenablog.com
位置までの2階積分の制御対象に比例制御では振動が減衰しないので、微分制御を追加する必要がある。位置までの2階積分の制御対象をPD制御したときのナイキスト線図は下図のようになる。
微分制御により位相が進み、剛体モードが左下から原点に近づいてくるために、やはり負荷位置のフィードバックが非常に不安定になりやすい状態になっている。2階積分の制御対象で考えても、やはりモード影響定数が負の共振で不安定になりやすいのである。
モード影響定数は正負どちらだと不安定か
では、なぜHDDの制御では、モード影響定数が正の時に不安定になると言われているのか。これは、共振周波数の違い(違い③)によると考えられる。下図は、剛体モードと無駄時間のみの制御対象をPD制御した場合のナイキスト線図である。

軌跡は、無駄時間によって原点の周りを渦巻き状に回る。モード影響定数が負の共振は、この剛体モードの軌跡の左側に円を描き、モード影響定数が正の共振は、剛体モードの軌跡の右側に円を描く。書き入れたように、ロボットの共振がある10Hzあたりでは軌跡は右上方向に向かっているが、HDDの共振がある(より少し低めの)数1000Hzあたりでは軌跡は右真横方向に向かっている。この図では無駄時間を200[s]としたが、上記文献によるとHDDの制御器では無駄時間は50[
s]程度なので、右真横方向に向かう周波数はもう少し高い周波数になり、HDDではそのあたりに共振がある。剛体モードの軌跡が右真横方向に向かうあたりの周波数に共振があるので、HDDではモード影響定数が負の共振は上側に円を描き、モード影響定数が正の共振は下側に円を描くことになる。
下図はモード影響定数が負の共振がある場合のナイキスト線図である。共振周波数が100, 200, 500, 1000, 2000Hzの時の軌跡を重ねている。ただし、図をわかりやすくするため、円の直径がだいたい同じになるようにを決めた。

共振周波数が500Hzまではゲインを上げると不安定になりそうであるが、1000Hz以上だと安定性に影響はなさそうである。
下図はモード影響定数が正の共振がある場合のナイキスト線図である。共振周波数が100, 200, 500, 1000, 2000Hzの時の軌跡を重ねている。

共振周波数が500Hzまではゲインを上げても安定性に影響なさそうであるが、1000Hz以上だと不安定になりそうである。
モード影響定数が正の時に不安定になるのか、負の時に不安定になるのかは、剛体モード+無駄時間のナイキスト軌跡が、共振周波数のときにどちら向きに進んでいるかによって決まる。つまり、制御システムの無駄時間と制御対象の共振周波数の関係によって異なるということだ。実軸のマイナス方向に円を描くのが、HDDの条件ではモード影響定数が正のときだが、ロボットの条件では負のときだということだろう。
